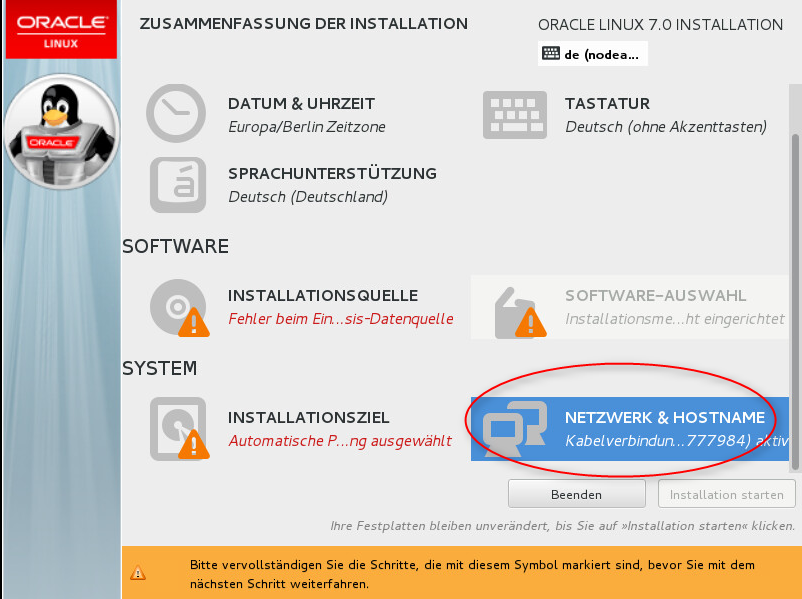
und prüfe, ob der Ethernet-Adapter überhaupt aktiviert ist. Falls nicht, ziehe den Regler rechts oben mit der Maus von Aus auf An. erst jetzt kannst du über das Netzwerk eine Installstionsquelle einbinden, beispielsweise als NFS-Share.
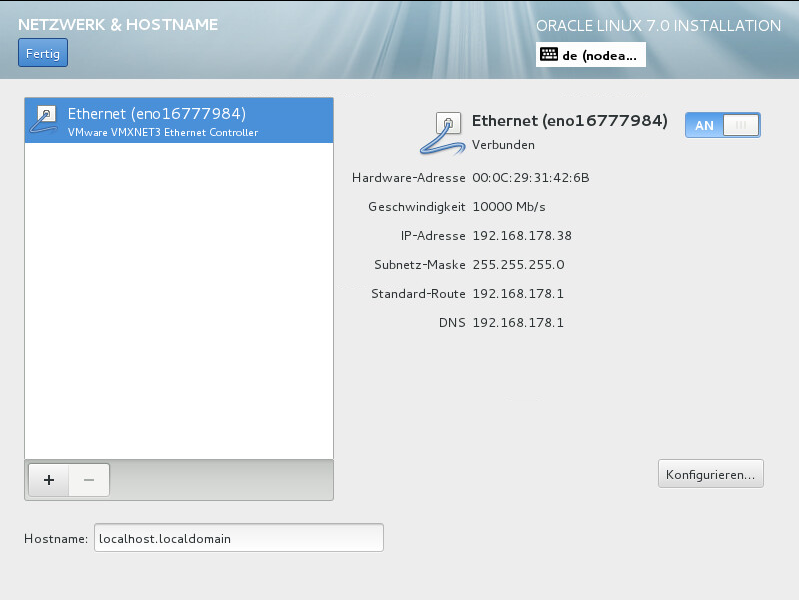
Mich persönlich hat dieser doch sehr rudimentäre Fehler bei der installation von Oracle Linux auf einem VMWare ESXi-System überrascht. Da Oracle Linux das einzig kostenlose Linux auf der Liste der unterstützten unix-basierten Betriebssysteme der SAP ist, wollte ich mir unbedingt ein virtualisiertes Testsystem aufbauen. Vor allem da es sich bei Oracle um einen Hersteller von Enterprise-Software handelt, war ich von diesem Problem dann doch sehr verblüfft.
Die Installationsquelle ist ebenfalls eine iso-Datei, die ihr von der Oracle Linux-Seite herunterladen ist. Sie nennt sich „Oracle Linux Media Pack“ und muss im Anschluss von euch gemountet werden. Kopiert den Inhalt des Media Packs mitsamt aller versteckter Dateien in eine FTP-, NFS-, HTTP- oder HTTPS-Freigabe. Das Einrichten einer NFS-Freigabe habe ich euch hier gezeigt. Die Dateifreigabe müsst ihr dann dem Installer nur noch als installationsquelle übergeben und schon könnt ihr das Betriebssystem installieren.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>
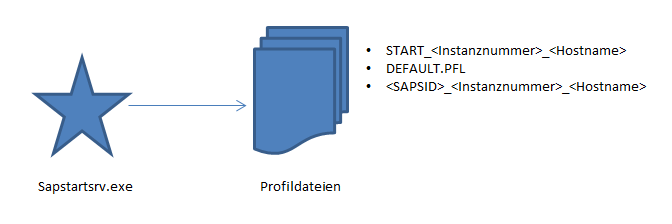
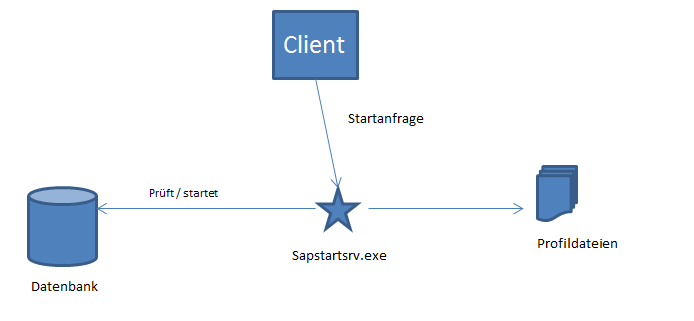
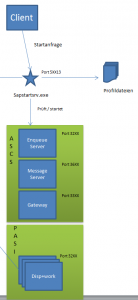
Diese Binary ist im Endeffekt nichts anderes als ein kleiner Webserver, der auf den port 5<Instanznummer>13 lauscht. Diesem Webserver können über Parameter, die der Binary übergeben werden, wichtige informationen übermittelt werden, die er letztendlich zum Starten und Verwalten der restlichen Instanzbestandteile braucht. Beispielsweise muss sapstart wissen, wo die profildateien der Instanz liegen, was ihm über den Startparameter pf=<pfad zur profildatei> mitgeteilt wird. Neben dem Instanzprofil mit namen <SAPSID>_<instanz>_<hostname> greift sapstart nocha uf die instanzübergreifende Profildatei DEFAULT.PFL und in älteren SAP-Releaseversionen noch auf ein instanzspezifisches Startprofil namens START_<instanznummer>_<hostname> zu.
sapstart hat jetzt alle nötigen Profilparameter, die notwendig sind, um die SAP-Instanz zu starten. Wie bereits besprochen, horcht sapstart auf dem Port 5<XX>13 nach eingehenden Anfragen. Beispielsweise also nach einer Anfrage, die SAP-Instanz zu starten. Diese Anfrage kann beispielsweise über die SAP Management Console unter Windows oder auch nur über das sapstart-Skritpe unter Linux/Unix erfolgen, oder auch aus der Ferne von einem anderen Rechner aus, wenn sapstart entsprechend konfiguriert wurde.
sobald sapstart eine Anfrage erhält, die SAP-instanz zu starten, tut SapStart dies antürlich auch. Dazu sind verschiedene Schritte notwendig. Zuerst müssen wir uns überelgen, wo ein SAP-System seine Daten her nimmt. NAtürlich aus der datenbank. Ohne Datenbank funktioniert kein SAP-System. Es macht daher keinen Sinn, irgendeinen Teil des SAP-Systems zu starten, bevor nicht sichergestellt wurde, dass auf die Datenbank zugegriffen werden kann.
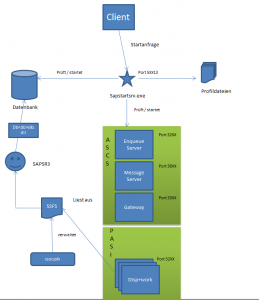
Deswegen ist das erste, was das SAP-System macht, in den profildateien nachzugucken, welche Datenbank verwendet wird, und zu überprüfen, ob die Datenbank-Instanz bereits läuft und falls nicht, diese zu starten.
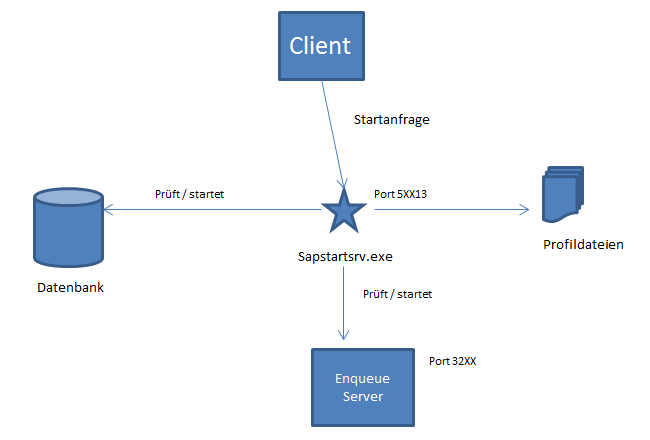
Nun wisst ihr aus meinem SAP Basis / NetWevaer-post, dass SAP bestimmte prozesse mitbringt, die mit der Datenbank kommunizieren müssen. da wäre zum einen der Enqueue-Server. Dieser kümmert sich um Sperren, die verhindern sollen, dass zwei Nutzer gleichzeitig an einem bestimmten Datenstand arbeiten und dabei unabhängig voneinander Änderungen machen, wobei derjenige, der als letzter speichert, die Änderungen des anderen einfach überschreibt. Datenbanken bieten zwar in From von Transaktionen einen rudimentären Schutz dagegen, dass Daten gleichzeitig bearbeitet und geschrieben werden können und schützen daher die Daten vor Korruption durch doppelte Schreibvorgänge, jedoch können immer noch zwei Benutzer die Daten ändern, ohne zu wissen, dass gleichzeitig jemand anderes an den selben Daten arbeiten möchte. Der Enqueue Server schützt vor diesem Dilemma. Es macht also keinen Sinn, das SAP-System mit der Datenbank kommunizieren zu lassen, bevor nicht der Enqueue-Server gestartet ist. Also startet sapstart den Eqneuueserver, der wiederum selbst auf den port 32<Instanznummer> lauscht.
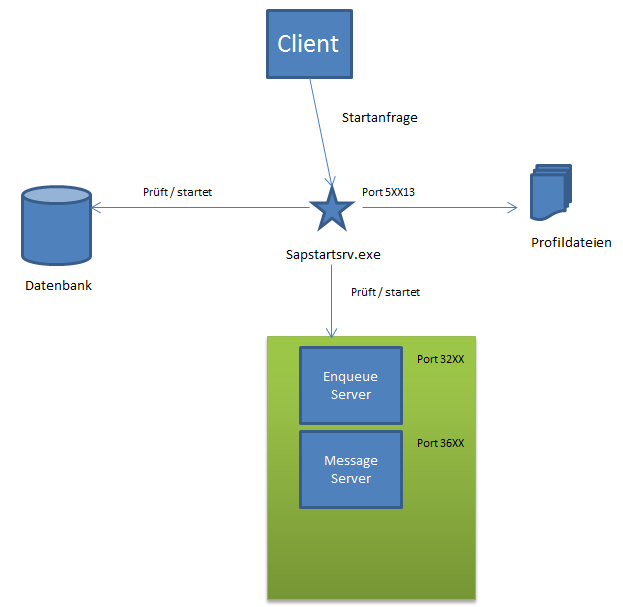
Desweiteren wissen Sie vielleicht bescheid über den sogeannnten Message Server. Das SAP System arbeitet ja intern mit sogenannten OpenSQL-Statements, spricht also einen möglichst allgemeingehaltenen SQL-Slang, um Datenbankoperationen auszulösen. Diese OpenSQL-Statements funktionieren antürlich nicht immer mit dem proprietären SQL-Slang des eingesetzten Datenbankmanagementsystems. Deswegen gibt es den Message-Server, der sich darum kümmert, dass die OpenSQL-Statements in das Native SQL der eingesetzten Datenbank übersetzt werden, bevor sie an die Datenbank geschickt werden. Also muss auch der Message Server hochgefahren sein, bevor eine SAP-instanz funktionieren kann, der seinerseits auf den port 36XX lauscht.
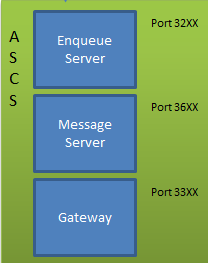
Zusätzlich nuss noch das Gateway gestartet werden, damit das SAP-System gleich beim Start mit fremden Systemen oder Drittanbeiterprodukten per RFC-Verbindungen kommunizieren kann. Sonst würde das system eventuell auf Fehler laufen. Mit dem Gateway-prozess sind nun alle komponenten der Zentralinstanz am Laufen.
Erst jetzt macht es Sinn, den eigentlichen Kernel des der Anwendungsserver-Instanz zu starten, den Dispatcher. Dieser kümmert sich um die Erstellung und Verwlatung von Workprozessen und muss dazu auf die daten aus der Datenbak zurückgreifen, wobei sich die Workprozesse innerhalb des Dispatchers dazu den Funktionalitäten von Message Server und Enqueue Server bedienen, wie wir ja schon aus dem Einführungspost in die SAP Basis erfahren haben.
Jetzt gibt es noch ein Problem. Damit der SAP Kernel mit der Datenbank kommunizieren kann, braucht es einen Datenbank-User, mit dem sich der Kernel a der Datenbank anmelden kann, und irgendwie muss der Kernel an das Passwort für diesen Nutzer kommen. Der nutzer SAPSR3 wird bei der Installation des SAP-Systems angelegt und das Passwort ist in einer verschlüsselten Datei gespeichert, der Datei SSFS. Diese Datei ist mit einem SAP-proprietären Verfahren gesichert, sodass die Datei nicht im klartext gelesen werden kann. Die infomrationen aus der SSFS-Datei kann nur über das Tool rsecssfx gelesen werden, die in der SAP-Installation enthalten ist. natürlcih kann man aber auch mit diesem Tool keine Passwörter aus der Datei auslesen.
nun ist es wichtig zu verstehen, dass es mehrere disp+work-prozesse auf Betriebssystemebene geben wird. Einer ist als Hintergrudnprozess eingesetzt, einer für die Verarbeitung von Dialoganfragen, einer für die Verarbeitung von Spool-Aufträgen (also Drucken) usw.
Desweiteren braucht der Dispatcher zur kommunikation mti der datenbank zusätzlich eine datenbankspezifische Bibliothek, die Datei db<datenbank>slib.dll, die je nach verwendeter Datenbank anders heißt.
Woher weiß die SAP-instanz eigentlich, wo die SSFS-datei liegt ubnd wie sie heißt? das legen Sie fest über die Umgebungsvariable RSEC_SSFS_DATAPATH
Eine letzte komponente, die ich Ihnen noch vorstellen muss, ist die sogenante SAPCPE-Komponente.
wie Sie vielleicht wissen, liegen alle wichtigen komponenten des SAP-Kernels einschließlich der disp+work.exe im Verzeichnis \usr\sap\<SID>\SYS\exe\[nuc|uc]\<Architektur>
Zunächst einmal müssen Sie verstehen, dass es unterhalb des ordners, der entweder nuc oder uc heißt, mehrere Ordner für verschiedene Architekturen geben kann. Warum ist das so? nun, es kann ja sein, dass wir mehrere dialoginstanzen betreiben, also mehrere Server, auf denen sich SAP-User anmelden können, die jedoch eine unterschiedliche Architektur haben.
Beispel: wir haben eine Datenbank, und unsere SAP-user können sich einmal auf einem Windows-Server mit Intel 64-Bit-Prozessor anmelden, nauf dem auch die ASCS-Instanz läuft, oder auf einem Linux Server mit Itanium-64-Prozessor, auf dem nur eine dialoginstanz läuft.
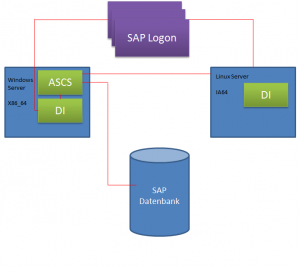
Wenn Sei das SAP System auf dem Windows Server starten, werden acuh die dialoginstanzen sowohl au dem windows als auch auf dem Linux server gestartet. Dabei werden die Dateien, die unter dem oben genannten Ordner gespeichert sind, je nach architektur in das Verzeichnis \usr\sap\<SAPSID>\<instanz>\exe\ kopiert. Das heißt der Widnows Ordner kriegt in seinen exe-ordner die Dateine, die unter SYS\exe\uc\ntamd64 liegen und der linux-server kriegt die Dateien,d ie unter SYS\exe\uc\uxia64 liegen. Das hat diverse Vorteile. Denn wenn Sie jetzt beispielsweise ein Kernel-Upgrade machen und mehere Server mti der gleichen Architektur haben, dann msüsen Sei das kernel-Ugprade nur einmal in dem exe\uc\<Architektur>-Verzeichnis der jeweiligen ARchitektur durchführen und der aktualosiierte Kernel wird beim Neustart des SAP-Systems automatisch auf alle Instanzen verteilt. Und wenn die instanzen dann durchgestartet werden, werden die soeben kopierten inhalte aus dem jeweiligen <instanz>\exe-Verzeichnis in das <instanz>\work-Verzeichnis verschoben, von wo aus sie ausgeführt werden. Das passiert, damit man eventuell die Dateien im <Instanz>\exe-Verzeichnis bereits manuell austauschen kann (also ohne sapcpe, wenn man das wünscht), während die instanz noch läuft, da die ausgeführten Dateine ja unter <Instanz>\work liegen und daher vom Austausch nicht betroffen sind.
die komponente, die für den Kopiervorgang der architekturspezifischen Dateien zustndig ist, nennt sich SAPCPE. Beim Starten eines SAP-Systems springt SAPCPE an zwei Stellen ein: Einmal vor dem Start der ASCS-Instanz, dort werden die Dateien für die Zentralinstanz kopiert, und einmal vor dem Start der Primary Application Server- und Dialog-Instanzen. Dort werden dann die Dateien für diese server in das jeweilige exe-Verzeichnis kopiert.
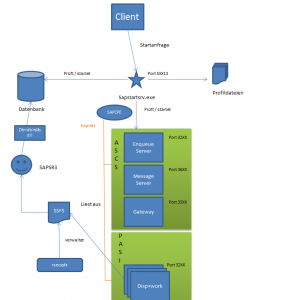
Jetzt haben wir alle wichtigen kompoennten beim Start einer SAP-Instanz sauber abgebildet. Ich hoffe der Beitrag war für euch informativ.
Jetzt wollen wir unser Wissen um den Systemstart einer SAP-Instanz noch ein wenig verschärfen. Das, was wir bisher als „client“ betrachtet haben, ist natürlich kein klassischer SAP-Client wie SAP Logon etc., sondern symbolisiert ein kommandozeilentool, mit dem man ein SAP-system starten kann, also eine Sitzung des Users <sid>adm auf dem Betriebssystem, auf welchem die ASCS-Instanz des Servers läuft. Jedesmal, wenn das Skript startsap (nicht zu verwechseln mit der sapstart.exe) aufgerufen wird, wird nicht nur der sobeen sehr detalliert durchleuchtete Prozhess angestoßen, sondern gleichzeitig der SAP OS Collecotr (saposcol) gestartet, den wir weiter unten noch kenenlernen werden. saposcol gibt es immer nur einmal auf einem host, egal wie viele SAP-isntanzen auf diesem System verfügbar sind. DAs Skriotp startsap startet also die sapstart.exe und saposcol
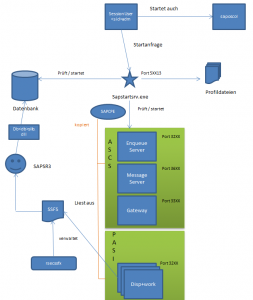
Das Testen von sapstartsrv, ob die Datenbank bereits läuft oder nicht, passiert mti dem Programm R3trans. Läuft die Datenbank, passiert nichts weiter. Läuft die Datenbank nicht, wird versucht, diese über das Skript startdb zu starten. Desweiteren ist noch erwähnenswert, dass auch der Dispatcher Zugriff auf die profildateien braucht, da der vordergrund-Dispatcher alle anderen disp+work-prozesse öffnet und dabei die Parameter in den Profildateien heranzieht.
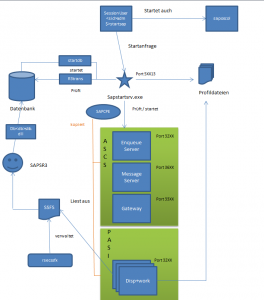
Bleibt nur noch zu klären, wie die Workprozesse des Dispatchers denn nun genau eine Verbindung mit der Datenbank herstellen. Wir beleuchten dies am Beispiel einer Oracle-Datenbank.
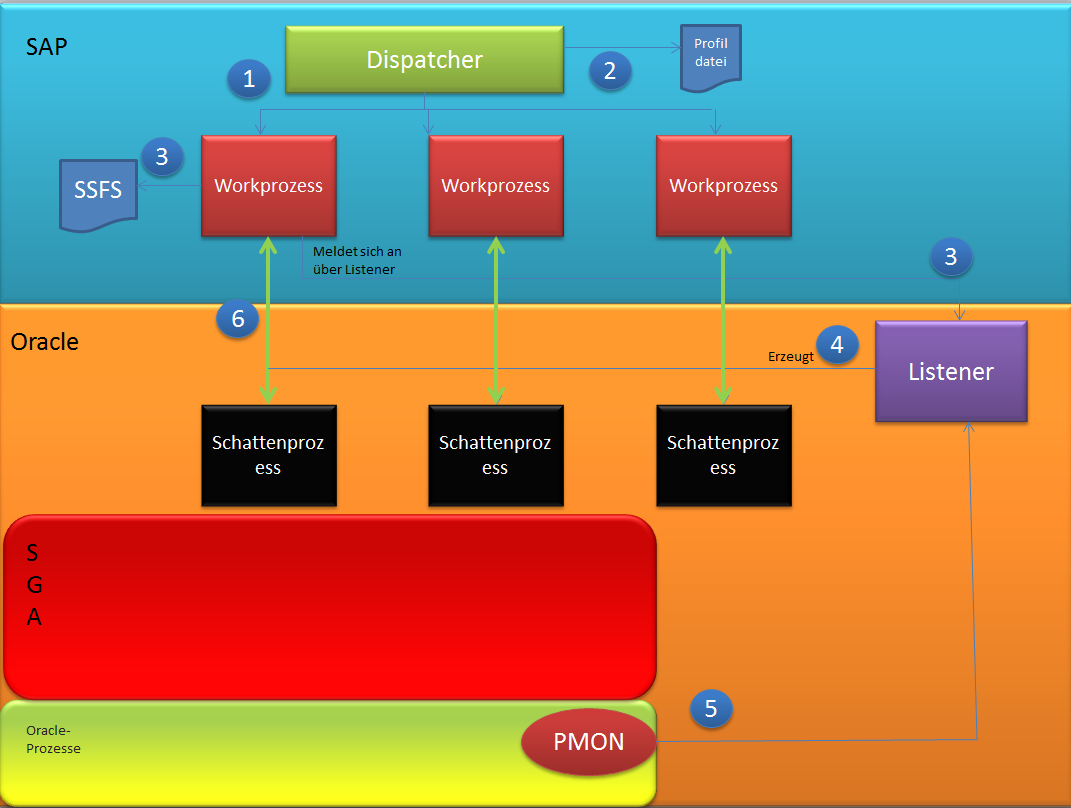
Der Dispatcher startet die Workprozesse (1), von denen widerum jeder einzelne versucht, auf die Datembank zuzugreifen. Wie wir bereits in meinem Post Start einer SAP-Instanz gelernt haben, guckt der disaptcher dazu in die Profildateien (2) und findet dort die Daten zum Verbinden an die Datenbank. Mitn diesne infomrationen ausgestattet, verbindet sich der jeeweilige Workprozess mit dem oracle Listener prozesss und authentifiziert über die Verbindungsdaten in der SSFS an der Datenbank an (3). Jeder einzelne Workprozess muss sich gesondert an der Datenbank anmelden.
Der Listener startet daraufhin die Schattenprozesse auf Oracle-Seite (4). Der Listener steht ständig in Verbindung mit dem Oracle PMON-Prozess, dadurch ist dieser ständig über den Status der datenbank informiert und kann diese informationen an die Schattenprozesse weiterleiten (5).
Ist der Schattenprozess erstellt, besteht zwischen Workprozess auf SAP-Seite und Schattenprozess auf Oracle-Seite eine direkte TCP/IP-Verbindung (6) und es muss nicht mehr der Umweg über den Liitener gegangen werden. Von diesem moment an hat der Workprozess über den Schattenprozess Zugriff auf das SGA und damti auf die Datenbank an sich.
für den Zugriff an sich laden sich Datenbank-Interface und ABAP-prozessor des SAP-workprozesses die datenbankspezifische Bibliothek db<dbms>slib.dll. Diese wiederum ist abhängig zur datenbank-proprietären Client-Software, also bei einer Oracle-Datenbank beispielsweise zum oralce Instant Client. Das heißt, damit ein SAP-Workprozess eine Verbindung zur Datenbank herstellen kann, braucht er sowohl sap-seitige als auch datenbankseitige Bibliotheken, die auf die verwendete Datenbank zugeschnitten sein müssen. Hier gezeigt am Beispeil einer Oracle-Datenbank.
Zu guter letzt wollen wir uns noch ansehen, wie sich Workprozesse über verschiedene Verfahren an einer Datenbank anmelden.
Aus der Oracle Datenbank kennen Sie vielleicht den sogenannten OPS$-mechanismus. Dazu wird mit dem Präfix OPS$ der Name eines Betriebssystembenutezrs in der Oracle-Datenbank abgespeichert. Versucht sich dann jemand, über den OPS$-Mechanismus anzumelden, indem er
sqlplus /
in die kommandozeile eingibt, dann scahut Oracle, ob es einen Datenbankbenutzer OPS$<Betriebssysem-Benutzername> gibt. Gibt es einen solchen nutzer, darf man sich automatisch ohne Passworteingabe als Nutzer OPS$<Betribessystem-Benutzername> an der Oracle-Datenbank anmelden. Oracle vertraut hier sozusagen der Authentifizierung des Betriebssystems.
Bei einem SAP-System läuft der Anemldevorgang noch etwas umständlicher.
Der Workprozess vernlasst, dass in der Datenbank in der Tabelle DBA_USERS nach dem User OPS$<SAPSID>ADM gesucht wird. im Datensatz für diesen User ist kein Passwort hinterlegt, es ist also leer. Die Anmeldedaten des OPS$<SAPSID>ADM-Users werden an den Workprozess gesendet. Mit diesen Anmeldedaten meldet sich der Workprozess an der Datenbank an und liest aus der Tabelle OPS$<SID>ADM.SAPUSER das Passwort für den User SAP<SID> aus. Diese Tabelle darf es in der datenbank nur einmal geben und sie gehört dem Benutzer OPS$<SID>ADM. Wir haben also nun das Passwort für den User, über den das SAP-System auf die Datenbank zugreift.
Sie können foglendermaßen prüfen, ob die Tabelle OPS$<SID>ADM.SAPUSER wirklcih dem Datenbanknutzer OPS$<SID>ADM gehört:
select OWNER from DBA_TABLES where TABLE_NAME='SAPUSER';
Gehört die Tabelle aus welchem Grund auch immer enmal nicht mehr dem Benutzer, müssen Sie sie neu anlegen.
drop table "<besitzer-datenbanknutzername"".SAPUSER;

creeate table "OPS$<SID>ADM".SAPUSER USERID VARCHAR2(256), PASSWD VARCHAR(256));
Die Session als Benutzer OPS$<SAPSID>ADM wird abgebaut. Nun versucht sich der Workprozess, sich als Datenbankbenutzer SAP<SID> anzumelden. Ist das Passwort aus dem Datensatz in der tabelle OPS$<SID>ADM.SAPUSER korrekt, kann sich der Workprozess als Datenbankuser SAP<SID> anmelden und nun mit der Datenbank arbeiten..Schlägt der Anemldeversuch fehl, versuch der Workprozess bei einem zweiten Versuch das Standardpasswort für diesen User, welches standardmäßig bei einer SAP-installation vergeben wird.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Der Diagnostics Agent ist eine zentrale Komponenten in einer SAP Solution Manager systemlandschaft. Sie wird genutzt, um zentralisierte Analysen und Monitoringaktivitäten für die SAP Netweaver Systemlandschaft berietzustellen. Sie hilft bei Tätigkeiten, die mit der root cause analysis (Fehlerursachenanalyse) zusammenhängen. Der daignostics Agent ist für die Verbindung zwischen Solution manager und managed Systems (verwalteten Systemen)zuständig, um informationen zu sammelön. Diese infomrationen werden von den managed systems an das SAP Solution Manager System zur Analyse gesendet.
Der SAP Host Agent implementiert verschiedene Software Lifecycle Management prozesse, wie etwa Monitoring und Administration, in ein SAP System. Die Hautpaufgabe des Host Agents ist das monitoring und das Mangement auf Betriebssystemebene. Er wird einmal pro physikalischem Host installiert, kann also für mehrere virtuelle SAP-Systeme / virtuelle Hosts zuständig sein, die auf einem physikalischen Host installiert sind. Er liefert daten an die SAP monitoring und Management-Lösungen. Der SAP Host Agent liefert dazu Zugriff auf Betriebssysteminformationen, beispielsweise die nutzung von virtuellem und physikalischem Speicher, CPU-Auislastung, Speicherplatzauslastung auf den Festplatten, die Ressourcennutzung laufebnder Prozesse, Informationen über Betriebssysteme und Datnebanken auf dem Host, und übernimmt auch das Log File Monitoring.
Zwischen Diagnostics Agent und SAP HOst Agent muss in der Regel eine trusted connection – eine vertrauenswürdige Verbindung – hergestellt werden. Beide Komponenten arbeiten zusammen, um Monitoring und Management für SAP-Lösungen zu gewährleisten. Damit diese Verbindung hergestellt werden kann, muss der Username des Diagnostics Agent als Profilapramter an den sAP Host Agent übergeben werden.
Der Diagnostics Agent muss einmal pro managed System / Virtual Host (also mehrfach auf einem physikalischen Host, wenn auf diesem mehr als ein SAP-System laufen) installiert werden. Er wird heutzutage auf neueren Netweaver-installation automatisch mitinstalliert. bei älteren netWeaver-Releases älter als Patch Level 14, muss der Diagnostics Agent noch manuell per SAPInst installiert werden.
Wir haben also einen SAP Host Agent pro physikalischem Host, und einen SAP Diagnostics Agent pro SAP-System, also manchmal mehrere Diagnostics Agent auf einem einzigen Host.
Der SAP Solution Manager bekommt dann nochmal selbst jeweils einen Diagnostics Agent und einen SAP Host Agent.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Als Master Data bezeichnet man Daten, die einmalig gespeichert werden und in allen SAP-Systemen einer Systemlandschaft abgerufen und verändert werden können. Wichtig dabei ist, dass die Daten nur einmalig abgelegt werden,also nicht jedes System seine eigene Datenquelle braucht, sondern sich alle Systeme von der selben Datenquelle bedienen – und dass die Daten somit konsistent und immer up to date für alle System zur Verfügung stehen. Desweiteren spart dies umständliche doppelte Eingaben in SAP-Systemen, was den Anwendern und Administratoren von SAP-Systemen Arbeitszeit spart.
Als Master data bezeichnet man Daten, die in regelmäßigen Abständen wiederkehrend abegrufen oder verändert werden müssen, oft von mehreren SAP-Systemen (gleichzeitig). Dazu gehören beispielswiese Kunden- und Lieferantendaten, die beim Verkauf und Ankauf von Produkten und Materialien immer wieder abgerufen werden müssen.
Das Master Data Management ist eine Applikationskomponente des SAP NetWeaver und wird standardmäßig mitinstalliert. sie kümmert sich um das Bestimmen der Datenquellen für Master Data, um die Entduplikation von doppelt vorahndenen Einträgen, um die Zusammenführung von verstreut herumliegenden Daten, Datenaustausch mit Geschäftspartnern und Einzelhändlern usw.
Die Master Daten kann man entweder von den einzelnen SAP-Systemen, oder zentralisiert von einem Zentral-System aus, warten. Beides hat vor- und nachteile.
In späteren Posts werde ich detaillierter auf das MDM eingehen.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>In diesen Installationsmedien sind alle Softwarekomponenten (software units) dieses SAP-produkts enthalten – ganz gleich, ob man diese später in seinem speziellen System braucht, oder nicht.
Es wäre natürlich kontraproduktiv, alle Softwarekomponenten zu installieren, ganz gleich ob man sie braucht oder nicht. Denn das würde zu unnötigen Performanceeinbußen durch Hardwarebelastung sowie durch unvorhergesehene Komplikationen zu Fehlern im System führen. Das wollen wir vermeiden.
Weil SAP-Berater Experten in ihrem Fach sind, installieren sie SAP-Produkte nicht einfach so drauf los. Sondern sie gehen mit einem Plan vor (erklärt in meinem Post SAP: Die PDf-Guides erklärt). Für jedes SAP-Produkt gibt es einen sogenannten Master Guide, der den SAP-Berater beim Planen der Implementierung eines SAP-Produkts unterstützen soll.
In diesen Master Guides geht es also darum, die Implementierung eines SAP-produktes zu planen – also sowohl in betriebswirtschaftlicher, als auch in informationstechnischer Sicht. Dabei stößt man auf die Frage, welche Softwarekomponenten man denn nun installieren soll, und welche nicht.
Um diese Entscheidung einfacher zu machen, hat SAP die Definition der sogenannten USage Types erstellt. Usage Types beschreiben einen ganz speziellen Zweck, den man mit diesem SAP-Produkt abbilden kann, etwa einen Service Desk, ein Central-SLD, oder ähnliches. SAP bindet an diese Usage Types, also an diese Nutzungsszenarien, einen Umfang an Softwarekomponenten (Installable Sotware Units), der installiert werden muss, um dieses Nutzungsszenario leisten zu können.
Das bedeutet: der SAP Systemadministrator plant seine Installation nur nach anhand von Usage Types, also daran, wie er das SAP-Produkt später nutzen will – und erfährt dadurch die zu installierenden Softwarekomponenten.
Die Usage Types, die der Administrator im Master Guide geplant hat, findet er später beim Installieren des SAP-.Produkts auch in der Installationsroutine wieder. hier kann er einfach die Usage Types auswählen, das Setup erkennt dann automatisch, welche Softwarekomponenten für diesen Usage Type installiert werden müssen.
Das, kurz gesagt, ist der Sinn von Usage Types. sie sind in jedem Master Guide in der Regel im Kapitel 4 beschrieben.
Neben den Usage Types spricht man im Master Guide auch von Processes – Prozessen. hier ist nicht von den Prozessen die Rede, die im Hintergrund auf einem Betriebssystem ablaufen, sondern sozusagen von Geschäftsprozessen, die betriebswirtschaftlich gesehen immer wieder im Unternehmen auftauchen.
diese Prozesse können beispielsweise das Rechnungsmanagement, die Materialverwaltung oder die Kundenbetreuung in einem Unternehmen sein, oder etwa der Service-Desk, der sich um die Probleme von Anwendern unserer SAP-Produkte kümmert und als Hotline zur Verfügung gestellt wird.
Diese Prozesse wiederum sind mit Usage Types verknüpft. Es kann sein, dass man für einen bestimmten Prozess mehrere Usage Types einplanen muss. Wenn man weiß, für welchen Prozess man welche Usage Types vorsehen muss, weiß der Administrator später, welche Usage Types er bei der installation eines Systems auswählen muss. Wählt er diese aus, werden dann automatisch die richtigen Softwarekomponenten installiert, um diesen Prozess abzubilden.
Bei der installation von Enhancement Packages in einem SAP-System begegnet man noch einer anderen Begrifflichkeit: Business Functions (BFs). im Endeffekt sind Business Functions neue, mit einem Enhancement Package hinzugekommene Funktionen in einem SAP-System. Diese Business Functions updaten bestimmte Softwarekomponenten eines SAP-Systems, um diese mit neuen Funtkionen zu bereichern.
So, wie bei der installation eines SAP-Systems Usage Types zu Prozessen zusammengefasst werden, werden Business Functions beim Update eines SAP-Systems zu sogenannten Technical Usages zusammengefasst.
Ein Technical Usage ist eine Zusammenfassung von Business Functions für eine bestimmte Produktinstanz.
So kann es etwa sein, dass man für eine bestimmtes technisches Nutzungsszenario verschiedene Business Functions installieren muss, die in der Regel zusammen in einem Erweiterungspaket ausgeliefert werden. Die einzelnen Business Functions werden dann auf diejeweiligen Softwarekomponenten anghewandt, die durch diese upgedatet werden.
Was sind Produkte und Softwarekomponenten?
ein produkt ist eine Applikation die bestimmte Geschäftsanforderungen eines Unternehmens erfüllt. Solche Produkte sind beispielsweise SAP ERP, SAP CRM usw. Produkte werden dabei unterteilt in Softwarekomponenten. So hat SAP ERP beispielsweise eine Softwarekomponente für sein HR-Modul, für sein FIN-Modul, aber auch Basismodule, die für den Netweaver zuständig sind – der sich wiederum darum kümmert, dass das produkt überhaupt läuft.
Zunächst einmal muss man verstehen, dass ein SAP-System aus verschiedenen Komponenten besteht. Es gibt sogenannte Basis-Komponenten, die für den Betrieb der Grundplattform, auf welcher alle SAP-Produkte laufen, zuständig sind. Das sind also die Softwarekomponenten für den Betrieb der netWeaver-plattform. Und es gibt Application-based Softwarekomponenten, die sich je nach installiertem SAP-produkt und -Release unterscheiden und für die Bereitstellung der Funktionen dieser Applikationen zuständig sind.
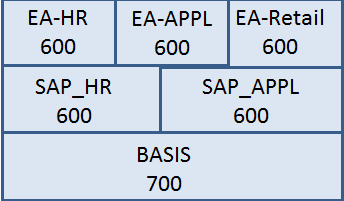
eine Softawrekomponente ist die kleinste verwaltbare Einheit im SAP-Softwaremodell. Sie sind deshalb auch die Basis für die anwendung von Support Packages. Eine Softwarekomponente wird dabei einer oder mehreren Produktinstanzen zugeordnet.
Was ist eine Produktinstanz?
Eine Produktinstanz ist ein Bündel aus Softwarekomponenten die sich gegenseitig brauchen, um auf einem System lauffähig zu sein. Sie müssen auf einem einzigen technischen System installiert werden. Ein technisches System ist dabei sozusagen SAP-Software, die sich auf einem einzigen Host befindet (die Datenbank darf heirbei noch auf einem anderen Host liegen). Das gesamte Produkt / SAP-System an sich kann auf mehrere Hosts verteilt sein, es können auch mehrere produkte auf einem einzigen physikalischen Host installiert sein. Aber die Softwarekomponenten in einer Produktinstanz müssen zusammen auf einem einzige tecnischen System installiert sein, damit sie laufen.
Produktinstanzen sind beispielsweise die TREX-Suchengine, die beim Suchen von Begriffen in einem SAP-System zum Einsatz kommen, oder einer der jeweiligen Applikationssofwtarekomponetnen wie beispielsweise SAP_HR, die wiederum abhängig davon sind, dass auf dem selben technischen System die Komponente SAP_APPL läuft. Dann machen SAP_HR und SAP_APPL zusammen eien Produktinstanz aus. Dabei wird auch ersichtlich, dass eine einzige Softwarekomponente bestandteil mehrerer Produktinstanzen sein kann. SAP_APPL wäre beispielsweise Bestandteil sowohl von der Produktinstanz Human REsources – zu welcher SAP_HR und SAP_APPL gehören, als auch der Produktinstanz Retail, zu der SAP_Retail und SAP_APPL gehören.
Heutzutage werden produktinstanzen dazu genutzt, um Usage Types und Technical Usages zu ersetzen (siehe unten). Eine Produktinstanz ist also ein neuerer Begriff für diese beiden älteren Definitionen.
Wenn man im Maintenance Optimizers updates für ein System durchführt, dann kann man diese Produktinstanzen auswählen, um diese getrennt voneinander zu updaten.
Was sind technical systems und product systems?
Wie bereits angeschnitten, kann eine bestimmte Produktinstanz eines SAP-produkts auf verschiedenen Systemen installiert sein. Man muss nicht ein SAP-produkta uf einem einzigen physikalischen Host installieren. Man aknn beispielsweise die Produktinstanz TREX, also die Suchengine für die Suchfunktion, auf einem anderen Host haben. Ein Technical System enthält also eine oder mehrere Produktinstanzen eines SAP-produkts, welches der SAP-Kunde in seiner Systemalandschaft einsetzt. Dabei können auf einem physikalischen Host mehrere technische Systeme sein – soll heißen: auf eniem physikalsichen Host können die Produktinstanzen verschiedener SAP-Produkte installiert sein. So kann man auf einem Server beispeilsweise sowohl produktinstanzen für SAP ERP, als auch für SAP CRM installieren.
Unter dem Begriff Product Systems fasst man nun alle technischen Systeme zusammen, die zusammengenommen ein installiertes SAP-Produkt formen. So kann man ein SAP ERP Product System beispielsweise aus einem technischen Ssytem für die Scuhengine TREX, einem Technischen Sytem für Human Resources und einem technischen System für Retail bestehen. Auf jedem technischen System läuft dabei die entsprechende Produktinstanz.
Was ist eine Produktversion?
Wie wir bereits gelernt haben, macht ein Product System ein bestimmtes installiertes SAP-Gesamtprodukt aus, welches ein SAP-Kunde einsetzt. Dieses product System als ganzes amcht also ein installiertes SAP-produkt aus, welches wiederum eine bestimmte Version hat. Bei der Version gibt man in der Regel den Release des SAP-rpodukts an, also beispielsweise SAP R/3, SAP ERP 2005, SAP ERP 6.0 – das sind jeweils aufeinanderfolgende Releaseversionen.
Releases sind sogenannte standalone Versions. Diese Produkte laufen ohne irgendwelche Zusatzprodukte von sich aus. Zu diese standalone produktversionen gibt es noch Add-on Produktversionen. :Das heißt, man kann bestimmte Erweiterungspakete (Enhancement Packages) installieren, die ein bestimmtes Release nochmal um einige funktionen erweitern. Die aktuelle Add-on-Version von SAP ERP 6.0 beispielsweise wäre
SAP ERP 6.0 and SAP EHP 7 for SAP ERP 6.0 – und sagt aus, dass auf den Release SAP ERP 6.0 das Erweiterungspakete EHP 7 aufgespielt wurde.
eien kleine besonderheit hierbei ist, dass EHP-Versionen des SAP Netweaver als standalone-Produktversion gelten. Die Produktversion SAP EHP1 for SAP NetWeaver 7.3 beispielsweise wäre eine standalone Produktversion.
Was ist eine Technical usage und was ist eien Business Function (BF) / Business Scenarios?
eine Business Function ist eine geschäftsbezogene Funktion in einem SAP-Produkt, die durch ein Bündel aus produktinstanzen oder einzelnen Softwarekomponenten bereitgestellt werden. Dabei kann eine Business Function auch einfach nur von einer einzigen Softwarekomponente oder von einer einzigen Produktinstanz bereitgestellt werden. Business Functions können auch neu dazu gekommen, wenn man ein Enhancement Package in eine Produktversio einspielt. Dann werden eine oder mehrere bestehende Softwarekomponenten so geupdatet, dass die entsprechende Business Function bereitgestellt werden kann. Wenn eine Business Function durch eine Transaktion im SAP-System abgebildet werden kann, bezeichnet man sie auch als Business Scenario. In der Regel ist es Aufgabe des sogeannnten Business project experts, die benötigten Business Functions und Business Scenarios, die innerhalb des SAP-Systems für das jeweilige Unternehmen gebraucht werden, zusammenzuführen. Der SAP-Systemadministrator muss dann auf der technischen Setie dafür sorgen, dass den Usern später diese Business Functions oder Business Scenarios zur Verfügung stehen.
Eine Technical Usage ist eine Art und Weise, verschiedene Produktinstanzen eines SAP-produkts auf technische Art und Weise zu verwenden. Alle für idese Technical Usage notwendigen produktinstanzen müssen installiert sein, damit diese angewandt werden aknn Jede Business Function ist einer technical usage zugeordnet – eine technical usage kanna us mehreren Business Functions bestehen. Eine Technical Usage muss installiert werden, um diese mit ihr verbundenen Business Functions bereitstellen zu können. Man kann dann beispielsweise im Solution Manager auswählen, welche Technical Usages man in seinem System haben möchte, um bestimmte Business Functions nutzen zu können – wenn man ein System updatet. Der soMan schlägt dann vor, welche Erweiterungspakete und Support Packages eingespielt werden müssen, damit diese technical usages bereitgestellt werden können. Aber auch bei der Neuinstallation eines SAP-Systems kann der Systemadministrator diese Technical Usages auswählen.
In der folgenden Abbildung sehen wir, dass mit dem SAP EHP7 eine neue Business Function namnes GEneral Ledger Account hinzugekommen ist. damit wir diese BF nutzen können, müssen wir die Technical Usage Central Application auswählen, wodurch dann der MOPZ des Solution Managers für uns die benötigten Updates (darunter das EHP7) auswählt. Dadurch werden die benötigten Softwarekomponenten wie beispielsweise SAP_APPL aktualsiiert, so dass im Endeffekt die gewünschte Business Function genutzt werden kann.
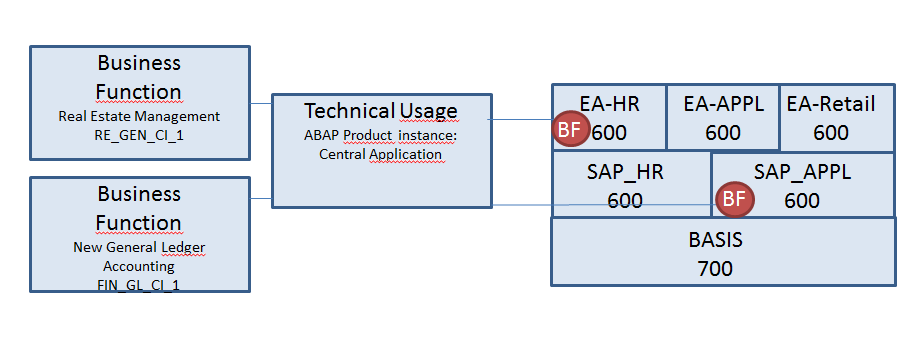
zunächst einmal muss man natürlich immer wissen, welche Business Functions man braucht. Dazu liefert SAP unter service.sap.com/erp-ehp / Business Functions in detail eine Liste aller Business Functions von EHP 1 zu EHP 7. Wenn man nur die Business Functions wissen möchte, die in einem bestimmten EHP dazu gekommen sind, dann guckt man am besten in die Release notes unter services.sap.com/erp-ehp / Release notes. Das ist jedoch in der Regel Aufgabe des Business Process Experts – es schadet jedoch nicht, grundsätzlich einen Einblick in die thematik zu haben.
Damit wir dann wissen, welche Technical Usages wir für diese Business Functions installieren müssen, können wir ebenfalls in services.sap.com/erp-ehp / Business Functions nachsehen oder uns die SAP Note 1818596 durchlesen.
Was sind Enterprise Services?
Na, raucht der Kopf schon? Das ganze geht noch komplizierter.
Mit der einführung der serviceorientierten Architektur (SOA) hat SAP begonnen, mit seinen Produkten sogeannnte Enterprise-Services auszuliefern. Enterprise-SErvices sind sozusagen Dienste, die mit Hilfe von SAP-Produkten angeboten werden. Die Diente sind in der ES-Wiki aufgezeichnet. Für jeden Dienst braucht man verschiedene Softwarekomponenten in einer bestimmten Version und bestimmte Business Functions, die aktiviert werden müssen.
Was wir zu diesem Zeitpunkt haben ist, welche Softwarekomponenten in welcher Version und welche Business Functions wird brauchen, um einen bestimmten Enterprise Service nutzen zu können. Aber wie wir ja wissen, brauchen wir zum updaten eines Systems über MOPZ die sogenannten TEchnical Usages. Deswegen muss man in einer SAP-note, aktuell die SAP Note 1818596 schauen, welche technical usages für diese sofwtarekompoennten / business functions notwendig sind.
Was sind Usage TypeS?
Usage Types definieren wie bestimmte Installationen einer SAP produktversion genutzt werden sollen und welche Möglichkeiten welcher Usage Type der IT-Systemlandschaft bietet. Sie sind daher im wesentlichen vergleichbar mit Business Functions. softwarekomponenten werden mit Usage Types verbunden, ähnlich wie sie andernorts auch mit bestimmten Business Functions und somit mit Technical Usages verbunden werden. Usage Types können auch mit produktinstanzen verbunden sein, die für diesen Usage Type installiert werden müssen.
Was sind installable software units?
installable software units sind produktinstanzen, die beim upgrade oder bei der installation einer SAP-produktversion mitinstalliert werden müssen, damit bestimmte Usage Types durch das System realisiert werden können. Usage Types sind also im Wesentlichen vergleichbar mit Technical Usages. Aber auch Standalone-Engines, die ohne ein übergeordnetes SAP-produkt lauffähig sind, also nicht von einem anderen SAP-produkt abhängig sind (etwa die Suchengine TREX), sind installable Software Units. Diese können (oder müssen) zusätzlich zum eigentlichen SAP-produkt installiert und eigenständig betrieben werden.
Installable Software Units können also sowohl Produktinstanzen sein, die von einem bestehenden SAP Produkt abhängig sind und in einer extra Instanz dieses Produkts betribeen werden, aber auch Standalone Engines, die keine Instanznummer bekommen und daher nicht vom System des Hauptprodukts abhängig sind.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Das ALM wurde ursprünglich eingeführt, weil lange Vertragslaufzeiten den Anwender einer Software in der Regel lange an bestimmte softwarelösungen binden, die er zuvor von einem Hersteller erstanden hat. das ALM soll dabei helfen, das Maximum an Gewinn aus der Lebensspanne einer Anwendungssoftware herauszuholen.
Das ALM besteht grundsätzlich aus zwei Bereichen: Der applikationsentwicklung (service Creation) und dem applikationsbetrieb (Service-Management). Diese bieden Bereiche werden wiederum in verschiedene Phasen unterteilt:
- Service Creation: die Applikation wird entwickelt, also ihre Anforderungen, ihr Entwurf und ihre Entwicklung bestehend aus Programmierarbeiten, Installationen, Konfigurationen und die erste Datenerstellung werden hier zusammengefasst.
- Anforderungsphase (Requirements Phase): Hier werdne die Anforderungen, bezogen auf Hardware, Benutzerfreundlichkeit, Reaktionszeit, Stabilität, Verwaltbarkeit etc. an die Software ausgearbeitet
- Entwurf: die Lösung wird entworfen. Dabei arbeitet man heraus, welche komponeten man in die Gesamtlösung implementiert, welche Komponenten man komplett selbst entwickeln muss und welche Drittanbieterlösungen man integriert.
- Implementierung: Die Anwendung wird das erste mal „aufgesetzt“ und in einer Entwicklungsumgebung in betrieb genommen. Hierbei soll sichergestellt werden, dass die Anwendung lauffähig und dazu bereit ist, in den produktivbetrieb übernommen zu werden. Tests sollen die Leistungsfähigkeit, Fehlerfreiheit und Benutzerfreundlichkeit der Software sicherstellen.
- Service Management: Hier wird die Software eingeführt, betrieben und stetig verbessert.
- einführungsphase. Die Software wird in eine Produktivumgebung überführt und darauf vorbereitet, produktiv betrieben zu werden.
- Betreiberphase. die Software wird gewinnbringend betrieben und löst ggf. ein altes Vorgängersystem offiziell ab.
- Optimierungsphase. Die Software wird stetig verbessert, indem beispielsweise der Anwendersupport, die Lauffähigkeit oder andere Kriterien verbessert werdne. Es werden regelmäßig Updates eingespielt, Prozesse werdne automatisiert, neue Komponenten werden der Landschaft hinzugefügt usw.
Wichtige Rahmenwerke für das ALM sind die Application Management bezogenen Dokumente der IT Infrastructure Libary (ITIL). ITIL entstammt ursprünglich der Management-Disziplin des IT Service Managements, kümmert sich also allgemein bezogen um die Verwaltung von IT-dienstleistungen, ganz gleich ob sie auf Anwendungssoftware basieren oder nicht. Da jedoch viele IT-Dienstleistungen auf Software basieren, hat ITIL einen umfassenden Grundsatz an sinnvollen ALM-Methoden.
Desweiteren gibt es ein auf das ALm zugeschnittene Rahmenwerk namens Application Services Library (ASL). Im Vergleich zu ITIl befasst sich das ASL ausshcließlich mit dem Application-Management und setzt sich intensiver damita sueinander. ITIL hingegen beschäftigt sich mehr mit IT-dienstleistungen im allgemeinen.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Nehmen wir beispielsweise an, Sie sind ein Unternehmen und haben bereits selber einige SAP-Systeme am LAufen. Wenn Sie jetzt feststellen, dass Sie noch ein SAP System brauchen, auf welchem der aktuelle Release des SAP Solution Managers läuft, könnten Sie jetzt selber ein Projekt starten – einen Server anschaffen und dort den SolMan drauf installieren, was unter Umständen mehrere Tage dauert.
Mit Amazon Web Services wäre es ihnen jetzt möglich, in einem Web-Wizard, den Sie ganz einfach per Browseroberfläche bedienen können, ein Solution manager system einer beliebigen Hardwarestärke binnen weniger Minuten aufzusetzen und bereitzustellen. Mit dem Server können sie sich dann mittels Cloud verbinden und ihn so in Ihre bestehende SAP-Systemlandschaft integrieren.
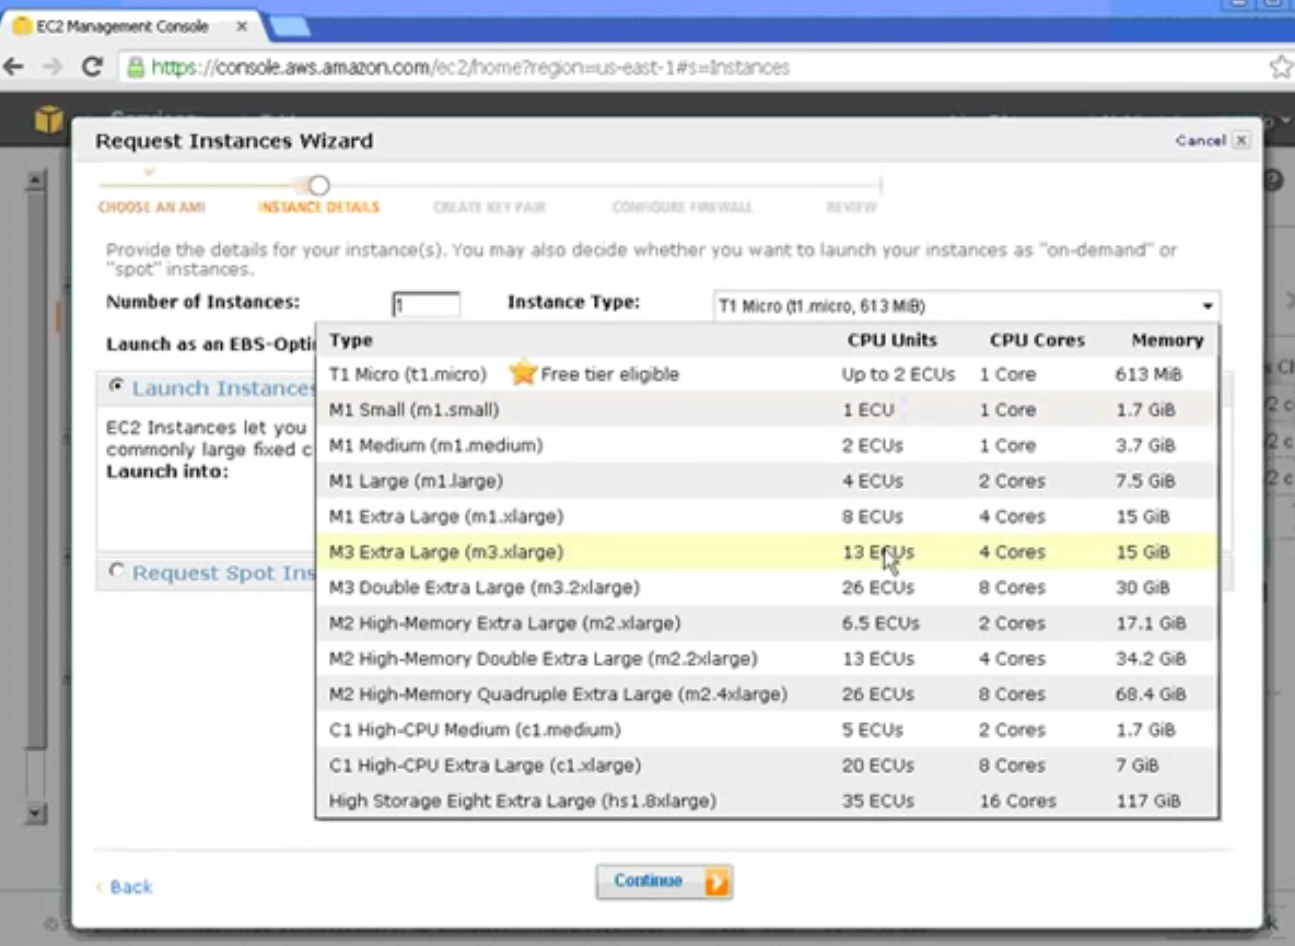
Ein Administraot kann sich dann ganz einfach per VNC / SSH auf den Server einloggen, nachdem dieser aufgesetzt ist, und dann noch kleinere Konfigurationsschritte vornehmen.
Das Betrieben eines Medium-Sized Servers kostet etwa 0,15 US-D pro stunde, also etwa 8 Dollar pro Monat. Ein Large Sized Server kostet 50 Cent pro Stunde. Angesichts dieser geringen Kosten wird schnell klar, dass die Amazon Web Services als cloud-basierte hostinglösung für SAP-Dienste auf jeden Fall in Frage kommt. Denn die kosten sind im Vergleich zum Eigenbetrieb sehr niedrig. Nachteil ist, dass man den Server nicht vor Ort hat und deswegen mit einigen Hürden des Cloud-Computings umgehen muss.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>SAP hat den Begriff BASIS für die Disziplin der SAP-Systemadministration abgelöst und nennt es heutzutage SAP NetWeaver Sytsem ADministration.
Was ist SAP NetWeaver?
SAP NetWeaver ist sozusagen die Plattform, welche alle Komponenten mit sich bringt, die notwendig sind, um SAP-Produkte zu betreiben. Dazu gehören beispielsweise der SAP Kernel, die SAP Basis-Softwarekomponenten, die grafische Benutzeroberfläche SAPGui usw.
Die Idee hinter SAP NetWeaver ist, dass die SAP-Produkte, also beispielsweise SAP SRM, CRM, SCM, PLM, oder SAP ERP, die wir allesamt in meinem post SAP – Geschichte und einführung kennengelernt haben, auf Basis von einem Web Application Server laufen und dabei plattformunabhängige Programmiersprachen wie ABAP oder JAVA nutzen. Der Vorteil bei diesen beiden Technologien ist, dass sie auf allen Betriebssystemen laufen – da der Code von einem Interpreter erst während der Laufzeit des Programms in Maschinencode übersetzt wird – das bedeutet: dem ABAP- oder Java-Code ist es grundsätzlich egal, ob er gerade auf einem Windows-, Linux- oder Unix-System ausgeführt wird. Der interpreter weiß, wie er für die jeweilige Plattform den Code interpretieren muss, damit die Befehle ausgeführt werden. Das einzige Plattform, welches betriebssystemabhängig kompiliert, heruntergfeladen und installiert werden muss, ist also der SAP NetWeaver selbst, aber nicht mehr die wirklichen SAP Produkte. Das verringert den administrativen Aufwand sowie Hürden bei der Umsetzung.
Das ist aber noch nicht alles, was hinter SAP NetWeaver steckt.Der NetWeaver versteht sich als serviceorientierte Integrationsplattform für alle SAP applikationen und für Drittanbieteranwenudngen, die mit den SAP Produkten in SYmbiose eingesetzt werden sollen. Deswegen hat der NetWeaver beispielsweise sogenannte N etWeaver Applikationen im Gepäck, die bestimmte Dienste bereitstellen, um innerhalb der SAP-produktlandscahft gewisse Aufgaben zu erfüllen (die wir weiter unten noch kennenlernen werden).
Desweiteren kann der SAP NetWeaver auch mit anderen Sprachen erweitert werden, beispielswiese microsoft .NET oder IBM Websphere. Das bedeutet: der pool an Entwicklern, die ein SAP-System von nun an mit ihren PRodukten bereichern können, ist ziemlich groß, da viele technologien unterstützt werden.
die NetWeaver applikationen
Das, was den SAP NetWeaver ausmacht, sind die applikationen, die er mitbringt. Auch diese dienen dazu, um SAP-Produkten die Grundlage bietet, um neue Funktionalitäten anzubieten.
Zu den NetWeaver-applikationen gehören:
- Web Application Server (WAS) / Application Server (NW AS)
- Business intelligence / Business warehouse (BI / BW)
- Process integration (PI), früher Exchange infrastrucutre (XI). Grundlage zur Integration von Drittanbieterlösungen in SAP-Landschaften.
- Enterprise Portal (EP). Der sinn von Enterprise Portal ist, dass User sich über Single Sign On
- NBetWEaver Composition Environemnt (CE)
- NetWeaver identity Management (IdM)
- NetWeaver mobile
- Master Data Manager (MDM). Kümmert sich um die Master Data, die transaktions- und produktübergreifend für die Anwender von SAP-Produkten zur Verfügung steht. Eine genauere erklärung von Master Data habe ich in meinem Blog-Post SAP ERP: Die Anwenderseite erklärt gegeben.
- MII: Manufacturing integration & Intelligence
Alle diese applikationen stellen also einen bestimmten Service zur Verfügung, der eine Aufgabe zu bewältigen hat. Alle Dienste zusammen stellen also die Produktivität einer netWeaver systemlandschaft dar.
Der NetWeaver Application Server
Der NetWeaver Application Server ist die Hauptapplikation des SAP NetWeaver. Denn: der Application Server ist quasi der Bereitsteller der SAP-Produkte an seine Anwender.Auf Basis des Application server wird die anwendungsschicht sämtlicher SAP-Produkte, also beispielsweise SAP ERP, SAP BI, SAP CRM, PLM, SLR usw. bereitgestellt. Nur mit einem Application Server im Hintergrund können Anwender eine Adresse des Application Servers eingeben und sich dann mit SAP Logon auf den Server connecten, wie in meinem Post SAP ERP: Die Anwenderseite erklärt. Auch andere Applikationen des SAP NetWeaver basieren auf dem NetWeaver Application Server, beispielsweise SAP BI, SAP PI, Enterprise portal usw. Alles basiert auf Basis eines Application Servers.
die Bezeichnung Netweaver Application Server bezeichnet die Weiterentwicklung des SAP Web Application Server. Der NetWeaver Application Server ist immer noch ein auf webtechnologien basierender Anwendungsserver mit neuem Namen.
ein SAP Application Server kann in drei Grundkonfigurationen installiert werden: mit einem ABAP Stack, Java Stack oder einem sogeannnten Dual Stack. Wie wir oben bereits gelernt haben, unterstützt SAP NetWeaver Applikationen, die auf Basis der Programmiersprachen aBAP oder Java entwickelt wurden. Diese applikationen liefert der application Server dann betriebssystem- und datenbankunabhängig an seine Anwender aus. Die Applikationen können entweder von SAP entwickelte Applikationen sein oder von Drittanbietern hergestellte applikationen, die dann von den Anwendern als Dienst in Anspruch genommen werden können. Die meisten SAP-Produkte sind auf ABAP-Basis geschaffen worden, das ABAP die SAP-eigene Technologie zum Entwickeln von Anwendungen ist. Deswegen braucht man beispielsweise für SAP ERP einen ABAP-Stack. Einige SAP-Technologien, die darauf ausgelegt wurden, dass Sie auch bei fremden ERP-Systemen der Konkurrenz eingesetzt werden können, sowie einige Anwendungen, die vom Einsatz von Java grundsätzlich profitieren, wurden mit Java realisiert – beispielsweise das SLD, welches ich in meinem Post SAP: Begriffe LMDB und SLD erklärt habe.
Man sieht also: für einige SAP-Produkte braucht man einen aBAP-Stack, für einige einen Java-Stack. Entweder man installiert zwei getrennte SAP NetWeaver-Instanzen mit zwei verschiedenen Stack-Konfigurationen und liefert auf diesen beiden instanzen die jeweiligen kompatiblen Produkte aus, oder man installiert einen sogeannnten Dual Stack: das ist ein NetWeaver Application Server ABAP Stack mit einer Java-Umgebung als Add-In, sodass auf diesem Application server auch java-Applikationen angeboten werden können. Der Umfang und die Performance eines Dual-Stacks ist allerdings nicht vergleichbar mit einem Standalone NW AS Java stack, weshalb in einigen Szenarien die Installation eines Dual Stacks nicht in Frage kommt oder mit einigen Nachteilen verbunden ist.
Der netWeaver Application Server wird auch Web Application Server genannt. Die beiden Programmiersprachen ABAP und Java sind dazu in der Lage, HTTP-Anfragen aus dem Intranet oder Internet zu bearbeiten und HTTP-Antworten zu liefern, die beispielsweise im HTML-format ausgegeben werden, sprich als normale Webpage, die man mit einem Webbrowser betrachten kann.
ABAP-Programme, die durch den netweaver Application Server ausgeführt werden, liegen mesitesn nicht als Binärdatei vor, sondern sie liegen als Quellcode in der datenbank. Wenn der Benutzer eine Transaktion aufruft, die ein bestimmtes ABAP-programm ausführen will, dann wird aus der Datenbank der Quellcode des ABAP-programms gehol tund im Anschluss live kompiliert und interpretiert. Bereits übersetzte ABAP-programme werden im ABAP-puffer gecached.
Dabei kann der Application Server sowohl als Webserver, als auch als Webcleinta uftreten. in seiner serverrolle akzeptiert er HTTP-Anfragen von anderen Webclients, etwa einem Browser oder von einem fremden NetWeaver Application Server, verarbeitet diese und liefert eine Rückantwort. In seiner Clientrolle schickt der Application Server Anfragen an fremde Webserver. Das kann beispielsweise ein fremder NetWeaver Application Server sein, mit dem man kommunizieren möchte – oder ein Drittanbieterprodukt, von welchem man bestimmte Daten abfragen möchte.
Instanzen und die Technischen Komponenten des Application Servers
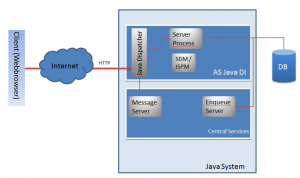
Je nachdem, ob man einen Application Server mit ABAP, Java oder dual Stack-Konfiguration installiert hat, besteht der Application Server aus verschiedenen Komponenten.
Die meisten dieser Komponenten werden jeweils einmal in jeder SAP-Dialoginstanz bereitgestellt. Installiert man einen NetWeaver Application Serverauf einem System, kann man damit mehrere Dialoginstanzen des Application servers auf einem einzigen physikalischen Host anbieten. Das wäre etwa so, als würde man einen Gameserver auf einem computer anbieten und diesen in zwei instanzen starten – auf einer Instanz mit dem Port 27019 kann man Capture the Flag spielen, auf einer anderen instanz mit dem Port 27020 kann man Deathmatch spielen. So in etwa kann man sich die Idee der Instanzen vorstellen. Jede Instanz hat dabei ihre eigenen technischen Komponenten.
Andere komponenten wiederum werden in einer sogenannten Zentralinstanz vorgehalten. Eine Zentralinstanz ist eine Instanz, welche die technischen Komponenten Message Server und Enqueue Server bereitstellt, die wir weiter unten noch vorstellen werden. Diese Komponenten werden instanzübergreifend bereitgestellt.
Jetzt kommt der Clou: Dialoginstanzen können über mehrere physikalische Rechner verteilt werden, es kann aber auf Wunsch nur auf einem dieser physikalischen Hosts eine Zentralinstanz geben. Der sinn davon ist, dass beispielsweise Dialoginstnazen auf mehreren Hosts im Clusterverbund zusammenarbeiten, damit sie die Last auf mehrere Server verteilen. Wie wir später noch lernen werden, kümmert sich dann auf einem dieser Hosts eine Zentralinstanz um die Verteilung der Serverlast auf die Dialoginstanzen auf den verschiedenen Hosts. Die Dialoginstanz ist dann nicht nur für die Dialoginstanzen auf dem eigenen, sondern auch für die Dialoginstanzen auf den anderen Hosts zuständig und verwaltet diese.
die Zentralinstanz bei einem ABAP stack ist die Instanz ASCS (ABAP System Central Services), die Zentralinstanz bei einbem Java Stack ist die SCS (System Central Services). Auf eine Zentralinstanz kann man als Anwender nicht die selben Anfragen stellen wie bei einer sogenannten Dialoginstanz. Eine Dialoginstanz ist dafür zuständig, mit dem anwender eines SAP-Systems zu interagieren, ihma lso beispielsweise Bildschirmausgaben als Antwort auf seine Anfragen, die er über SAP Logon stellt, zu liefern. Ein Anwender kann per se mit einer Zentralinstanz alleine also noch nichts anfangen.
Der (Web) Dispatcher
Eine wichtige Komponente ist der web Dispatcher. Der Web Dispatcher ist dafür zuständig, dass der NetWeaver Application Server HTTP-Anfragen aus dem Intranet oder Internet bearebeiten und beantworten kann. Somit ist es beispielsweise möglich, einen NetWeaver Application Server mit einem Webbrowser mittels Web-Administrationspanel zu administrieren oder zu überwachen, oder beispielsweise kann man bestimmte SAP-dienste als Anwender mit dem Webbrowser in Anspruch nehmen. Der Web Dispatcher öffnet für jede Anfrage eines Clients einen sogeannnten Workprozess (WP) für ABAP oder einen Server Prozess (SP) üfr Java. Ein Workprozess / Serverprozess besteht aus einer ABAP oder Java Virtual Machine (ABAPVM / JVM), in welcher dann ABAP- oder Java Code ausgeführt wird, um die Anfrage zu bearbeiten. Die Workprozesse sind voneinander abgeschottet, das heißt jeder Workprozess hat seine eigene kleine VM, in welcher der code ausgeführt wird. So können sich die Workprozesse nicht gegenseitig in die Umgebung pfuschen, indem sie sich beispielsweise ihre Umgebungsvariablen gegenseitig abändern. In idesem Workprozess wird also die Anfrage eines Nutzers letztendlich bearbeitet – als Ergebnis kommt eine Antwort heraus.
Alle Anfragen von Anwendern und Administratoren an das SAP-System gehen an diesen Dispatcher. Der Dispatcher entscheidet dann, an welche Teilkomponente des Application Servers die Anfrage weitergeleitet werden soll.
Anfragen, die von einem Webbrowser aus gestellt werden, gehen zuerst an den sogenanten Internet Communication Manager, den wir weiter unten noch vorstellen, und werden von diesem dann an den Dispatcher weitergeleitet. Anfragen von SAP Logon / SAPGUI gehen direkt an den Dispatcher. Umgekehrt gehen Antworten an SAP Logon Nutzer direkt vom Dispatcher aus, Browser-Antworten werden vorher den den Internet communication Manager weitergeleitet, der die Antwort dann meistens als HTML-Seite an den Browser des Nutzers ausliefert.
Dialoganfragen beispielsweise, die gestellt werden, wenn ein User mit SAP Logon eine Transaktion, eine Ansicht etc. aufruft, werden dann an die Dialogkomponenten weitergeleitet.
Background-Jobs, die meistens von Administratoren angestoßen werden und die im Hintergrund ohne Darstellung eines Dialogs ablaufen, werden an die Background-komponenten weitergelitet.
einen Dispatcher gibt es genau einmal pro Instanz.
Dialogworkprozesse
Dialogworkprozesse führen die zu einer vom User angeforderen Transaktion gehörenden ABAp-programme aus und greift dabei auf das Datenbanksystem zu. Ein Dialogworkprozesss besthaus verschiedenen Teilen.
Der Dynpro prozessor nciht die vom Dispatcher zugeteilten Transaktionsschritte, extrahiert daraus die vom Benutzer eingegebenen Daten., schreibt diese in in Teile des Speichers und leitet sie an den ABAP-prozessor weiter. Vor der Ausgabe bereitet der Dynpro-Prozessor das Ergebnsi der Transaktion vor, um es dann an die GUI zu schicken. Häufig benötigte Daten schreibt oder holt sich der Dynpro-Prozesor aus dem Roll-Puffer.
Der ABAP-Prozessor ruft ABAP-Programme auf, die für den aktuellen Transaktionsschritt nötig sind. Befindet sich das benötigte ABAB-Programm noch nicht im ABAP-puffer, wird es dorthin geladen. ist das programm noch nicht kompiliert worden, wird es erst übersetzt und dann in den Puffer und im kompilierten Zustand neu in die Datenbank geschrieben.
Die Datenbankschnittstelle übernimmt die Datenoperationen, die ihr durch den ABAP-Prozessor zugeteilt werden, etwa das Einfügen in oder das Änder von Datensätzen, oder das Abholen von ABAP-programmen oder das Auslesen von Daten aus der Datenbank. Sie verwaltet außerdem den Tabellenpuffer, der einen schnelleren Zugrif auf Daten ermöglicht. Sie übersetzt außerdem die Anfragen, die der ABAP-Prozessor in Open SQL stellt, in das native SQL des jeweiligen verwendeten Datenbankmanagementsystems.
Der Task Handler kümmert sich um das managemnt der Zusammenarbeit zwischen diesen Bestandteilen.Jedem Dialog-Workprozess wird dazu genau ein Datenbank-Serverprozess zugeordnet. SAP nennt dies einen Schattenprozess.
Batchworkprozesse
Batchworkprozesse sind für länger laufende Transkationen gedacht, die ohne ständige Interaktion mit dem Nutzer in der Stapelverarbeitung abgearbeitet werden können, gedacht.
Spoolprozesse
Sie dienen der Asugabe auf Druckern, PDF-Druckern und ähnlichen Geräten
Verbucherprozess (UPD).
– to be continued –
Der internet Communication Manager (ICM)
Der internet communication Manager ist dafür zustöndig, die Verbindung mit dem Application Server per Browser herzustellen und aufrecht zu erhalten, so dass der Application Server ABAP über das Internet per Browser erreichbar ist. Er empfängt einerseits HTTP-Anfragen über das Internet und leitet sie beispielsweise an den oben schon vorgestellten WEb Dispatcher weiter. Liefert der Web Dispatcher die Antwort auf eine solche Browser-HTTP-Anfrage, leitet er diese zum ICM weiter, so dass dieser die Antwort dann anschließend wieder zum Absender der Anfrage – meist als HTML-Seite an den Browser des Nutzers – übermitteln kann.
Der ICm kümmert sich nicht um Anfragen, die per SAP Logon an den Server gestellt werden. Diese gehen direkt an den Dispatcher und werden auch direkt von diesem beantwortet.
SAP Gateway Prozess
Der SAP Gateway Prozessist ausschließlich im NetWeaver Application Server ABAP Stack vorhanden. Er darf nicht verwechselt werden mit dem Produkt SAP NEtWeaver Gateway. dieses Produkt ist nämlich eine andere Technologie, die zum Datenaustausch von Daten und funktionalitäten eines SAP-Systems mit Geräten zuständig ist. Der SAP Gateway Prozess, über den wir hier reden, ist zuständig für die Kommunikation mit anderen externen SAP-Systemen oder mit anderen SAP-Produkten oder Drittanbieterprodukten auf fremden Hostsystemen. Der Gateway-Prozess sit für die externe kommunikation nach außen zuständig, der unten noch vorgestellte message-Server für die interne kommunikation zwischen den SAP-Applikationsservern. Mit dem Gateway-prozess Diese Kommunikation erfolgt über Remote Function Calls (RFC). Das bedeutet: Über das Netzwerk werden auf dem NetWeaver Application Server ABAP Funktionen, Routinen und Methoden aufgerufen, die eine Antwort auf die anfrage des Absenders des RFC generieren. So kann man beispielsweise von einem anderen SAP-System aus einen User auf dem fremden Application Server ABAP erzeugen, indem man mit einem RFC die Funktion zum Erzeugen eines Users aufruft. das geht natürlich nur, wenn zuvor eine Art Vertrauensstellung zwischen den beiden Servern erzeugt wurde und de rUser auf dem Absender-Server die Berechtigung für diesen RFC hat.
Der Messageserver
Der Messageserver ist immer nur auf der Zentralinstanz eines Application Server verfügbar. Der Messageserver ist für die Clusterverwaltung, also das Load-Balancing, zuständig. Er verteilt die Last von Anfragen wenn möglich auf verschiedene Instanzen, die im Cluster-Verbund zusammenarbeiten. Damit das geht, wird der Messageserver eben in der Zentralinstanz zur Verfügung gestellt. Desweiteren msus er dazu in der Lage sein, Benutzernameldungen entgegenzunehmen und die Benutzer auf die verschiedenen Applikatiosnserver verteilen zu können. Desweiteren verwaltet er, wie der Name schon seagt, den anchrichtenaustausch zwischen den Appkikationsservern, um beispielsweise Sperren über das ganze SAP-System hinweg zu setzen doer batch-Aufträge auf die verschiedenen Applikationsserver zu verteilen. Neue Applikationsserver, die dem SAP-System hinzugeügt werden, melden sich beim Messageserver an.
Der Enqueue-Server
Der Enqueue-Server ist zuständig für das sogenannte Lock-Management. Er ist zuständig für die Verwaltung von Sperren, wenn bestimmte Trnaskationen ausgeführt werden. Wenn beispielsweise gerade die Daten über einen Kunden bearbeitet werden, kann nicht gleichzeitig ein anderer anwender ebenfalls die Daten ändern, weil sonst der eine die Änderungen des anderen überschreiben würde. Darum kümmert sich das Lock Management und somit auch der Enqueue-Server. Damit das funktioniert, wird der Enqueue-Server auf der Zentralinstanz bereitgestellt.
Der instanzcontroller
Der instanzcontroller existiert nur auf einem Application Server Java Stack. Er kontrolliert den LEbenszyklus der AS JAva Instanz.
Software Deployment Manager (SDM) und JSPM ( Java Support package Stack)
Der Software Deployment Manager ist Java-Stack-exklusiv. Er kommt in einem Java Stack in jeder Dialoginstanz einmal vor. Der SDM wurde in früheren Java Relases genutzt, um Support Package Stacks in einem Java AS einzuspielen. Heutzutage wird der Java Support Package Stack (JSPM) genutzt. Bei sind pro DI einmal vorhanden.
Der Java Connector (JCo)
Der JCo ermöglicht es, dass in Java geschriebene Programme mit dem SAP-System kommunizieren können und umgekehrt. Er verbindet sozusagen die applikationen in einem Java-Stack mit dem eigentlichen System. Der JCo erlaubt dabei Kommunikation in beide Richtungen: inbound (Java ruft ABAP) und outbound (ABAP ruft Java). Zum DAtenaustausch werden objektorientierte Java BAPIs eingesetzt. Als Behälter für den Datenaustausch zwischen java- und SAP-porgiorammen dienen sogenannte IDocs.
Wir halten fest: Eine Instanz eines SAP-Systems ist zusammengesetzt aus
- einem Dispatcher
- den zu diesem Dispatcher gehörenden Workprozessen
- gegebennfalls einem Internet communication Manager
- den zugeordneten Hauptspeicherbereichen (Puffer etc.)
instanz eines SAP-Systems sind nicht gleichbedeutend mit einer instanz eines Datenbanksystems. Dei mit einer SAP-instanz angebotenen Dienste werden gemeinsam mit dieser instanz gestartet bzw. gestoppt. Alle Komponenten einer Instanz werden über ein gemeinsames instanzprofil konfiguriert.
Der Start einer instanz beginnt mit dem Start des dispatchers. Ein Dispatcher bracuht gleichzeitig immer Minimum zwei Workprozesse, um zu starten. Es können auf eniem Rechner mehrere Dispatcher konfiguriert werden, die jedoch in verschiedenen instanzen sein müssen. Jeder dispatcher hat dabei einen eigenen Port. Die erste instanz / der erste Dispatcher haben dabei den Port 3200, alle weiteren werden hochgezählt.
Eine instanz ist dabei immer Applikationsserver mit den Applikationen, die ihr dispatcher über seien Workrpozesse zur Verfügung stellt. die Clients verbinden sich dazu auf die gewünschte Instanz und können dann mit den angebotenen Applikationen arbeiten.
Verbindungsaufbau zwischen Frontend / Client und Backend / Applikationsserver
Wenn sich nun ein Nutzer mit seinem SAPGUI-Frontend oder mit einem Webbrowser auf eine SAP-Instanz als Applikationsserver verbindet, gibt es einen bestimmten Ablauf, der durchwandert wird, bis eine Verbindung zsutande kommt. Damit eine Vebridnung afugebaut werden aknn, braucht SAPGUI bestimmte Angaben wi etwa Hostname / IP, Instanznummer usw. Diese APrameter trägt der Anwender in das Programm SAPLogon ein.
SAPGUI nimmt die Parameter, die es von SAP Logon bekommen hat, und startet eine Anfrage beim Message Server der Central Services Instanz eines SAP-Systems, dass man sich mit einer bestimmten Instanz dieses Systems verbinden möchte. Der messageserver sagt dann der SAPGUI des Benuzters, auf welchem Host die gewünschte Instanz zu finden ist. Daraufhin baut SAPGUI eine neue Verbindung auf – diesmal direkt mit der ausgewählten instanz. Die Instanz reagiert und schickt SAP GUI den Anmeldebildschirm zum Login eines Benutzers. Dazu schickt der Dispatcher zunächst einfach einen anmeldebildschirm an das sAPGUi des nutzers. Dieser trägt seine Anmeldedaten ein und schickt diese wieder an die instanz. Der Disaptcher bekommt die anmeldedaten, fndet einen freine Workprozess zur Abarbeitung der Anmeldung und übergibt diese Daten an den Workprozess. Der Wrokprozess wiederum prüft durhc eine Anfrage an die Datnebank, ob die Anemldedaten korrekt sind. Wenn das der fall ist, baut der Workprozess das Menü SAP Easy Access auf, welches der Dispatcher an das SAPGUI des Nutzers sendet, damit dieser arbeiten kann.
Transaktionsablauf
Grundsätzlich läuft die Abarbeitung einer Transaktion zwischen SAPGUI und einer SAP-Instanz sehr ähnlcih ab wie der Anmeldeprozess. Wenn eine Transaktion aus mehreren Bildschirmbildern bestehen sollte, wird die ababreitung in der Regel auf mehrere Workprozesse verteilt. Diese Verteilung nennt man „Workprozess-Multiplexing“. Bei jeder dieser Bildschirmteile spriht man wiederum von einer Transaktion.
Das heißt aber auch, dass eigentlich zusammengehörende Transaktionen, die nur zusammen ein betriebswirtschaftlich verwertbares Ergebnsi erzielen können, voneiannder abhängig sind. Wenn einer der workprozesse ausfällt, gehen die Bearbeitungsschritte der anderen Workprozesse ins Leere. Daher ist in SAP-Systemen das Verfahren der asynchronen Verbuchung gang und gäbe.
Shared memory
Die kommunikation zwischen den weiter oben angesprochenen Workprozessen erfolgt über gemeinsame Speichebrereiche (shared memory). Damti diese Workprozesse effizient arbeiten können, müssen diese Puffer sauber dimensioniert und befüllt werden. im sogenannten R/3-Tabellenpfufer werden die Daten genutzter Tabellen gecached. Braucht ein Workprozess nun Daten aus der Datenbank, wird zuerst geprüft, obn diese schon im Tabellenpuffer vorrätig sind. Wenn nämlich vorher schon ein anderer prozess die daten aus der DB geholt hat, können die Daten wiedervrwendet werden.
Wie wir bereits wissen, liegen die übersetzten und kompilierten ABAP-programme ebenfalls in einem Puffer vor. Je länger ein SAP-System läuft, desto optimaler sind die Puffer befüllt Die Pfufer gehen leider verloren, sobald ein SAPM system neu druchgestartet wird.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Sowohl für Berater und Administratoren, als auch für Anwender selbst ist es interessant, die Anwenderseite eines SAP ERP-Systems kennenzulernen. Schließlich will man ja auch als Administrator wissen, welche Dienste man seinen Anwendern letztendlich anbietet.
Desweiteren ist dieser Beitrag auch für Administratoren interessant, die das erste mal mit der grafischen Benutzeroberfläche SAP EasyAccess unter SAP Logon arbeiten und daher eine kleine Starthilfe haben wollen.
In diesem Post möchte ich eine kleine Einführung darüber bieten.
SAP Logon – das Frontend
In dem oben verlinkten post haben wir von einer Drei-Stufen-ARchitektur gesprochen. Das heißt, die Darstellungsschicht bei SAP ERP ist von der Anwendungs- und Datenhaltungsschicht getrennt. Die Datenhaltungsschicht wird durch einen Client, der auf den Rechnern der Anwender läuft, sichergestellt. Mit diesem Client ist es also möglich, sich auf einem SAP-System einzuloggen und dessen Benutzeroberfläche grafisch darzustellen.
Dieser Client nennt sich SAP Logon. Man findet ihn im SWDC unter Installations and Upgrades / Browse our Download catalogue / SAP frontend Components / SAP GUI for XXX
Zum Downloaden von SAP Logon im SWDC braucht man einen S-User. Nur dann bekommt man Zugriff auf das Download-Portal. Nach der installation von SAP Logon kann man das Tool starten und sich auf einem SAP ERP Server, dessen Credentials man kennt, anmelden.
SAP Logon wird oft mit SAPGui verwechselt. SAPGui ist eigentlich nur eine Komponente, welche die Prozesse in SAP-Produkten grafisch darstellt. SAPGUI ist also häufig als Komponente in einem Paket von SAP-Produkten enthalten. SAP Logon ist das Tool, welches die komponente SAPGUI aufruft und dadurch die grafische Darstellung letztendlich einleitet. Man kann sAP GUI aber beispielsweise auch ohne SAP Logon starten. Das passiert beispielsweise, wenn man ein SAP-Produkt grafisch installiert, dann wird vom Setup-Programm SAPINST die Komponente SAPGUI aufgerufen.
Aufgrund der umgangssprachlichen Verwendung von SAP Logon findet man nun aber selbst auf SAP’s Service Market Place Informationen und downloads zu SAP Logon, wenn man nach SAP GUI sucht. Diese komponenten muss man in der Regel bei der Installation von SAP Logon auf seinem System auswählen, wenn man sie braucht. Natürlich kann man sie aber auch nachträglich nachinstallieren.
Mit SAP GUI kann man sich von Haus aus nicht auf jedem SAP-Produkt einloggen. Für einige SAP-Produkte sind Zusatzkomponenten notwendig, die zusätzlich zu SAP GUI dazu installiert werden müssen. Das ist der Fall bei
- BW (Business information WArehouse / Business Intelligence
- SCM (Supply Chain Management)
- APO (advanced Planner & Optimizer)
- SEM (strategic Enterprise Management) und
- KW (Knowledge Warehouse).
In Unternehmen installiert sich der Anwender eines SAP-Systems in der Regel sein SAP Logon nicht selbst. Das erledigt im Vorfeld meist der Administrator der Client-Systeme.
Wenn der Anwender dann SAP Logon startet, erhält er folgende Übersicht.
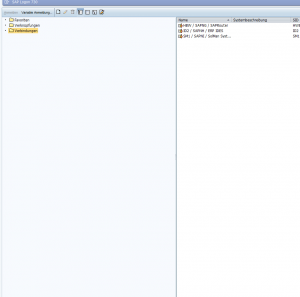
Rechts findet man eine Übersicht bereits vorkonfigurierter Systeme, die ggf. der Administrator der Clientsysteme bereits im Vorfeld dort platziert hat. Der User kann jedoch auch selbst neue Systeme, deren Anmeldedaten er kennt, über einen Klick auf das Neu-Icon (Papiersymbol) hinzufügen. Das sieht dann so aus
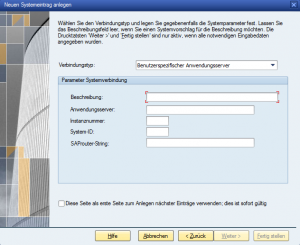
Systeme, Instanzen, Mandanten und Buchungskreise
Bei Anwendungsserver wird sozusagen die Adressse des Servers eingetragen, hierbei kann auch einfach nur der Hostname (etwa id2.meine-firma.de) eingetragen werden, oder aber eine IP-Adresse. Anders als bei anderen Clientlösungen üblich, wird hier aber auf keinen Fall durch einen Doppelpunkt im Anschluss ein Port mit angegeben. Warum, erfahren wir gleich
Die instanznummer bezeichnet die SAP-instanz, auf welcher man scih einloggen will. Instanzen werden bei der installation eines SAP-Produkts festgelegt. ein SAP-Server, auf welchem ein SAP-Produkt läuft, kann für dieses Produkt eine oder mehrere Instanzen haben. Für jede instanz werden extra Start-/stoppskripte, Konfigurationsdateien, Betriebssystemuser und SAP-User erstellt. Man kann also mit nur einem einzigen installierten SAP-Produkt beispielsweise zwei isntanzena fu zwei verschiedenen Serversystemen installieren. Die beiden instanzen werden dann für jeweils unterschiedliche betriebliche Aufgabengebiete verwendet, was die perforamnce verbessert. wenn beispielsweise eine Applikationsserver-Instanz für die Materialverwaltung und eine für das Kunden- und Auftragswesen vorgesehen ist, können die Applikationsserver-Caches effizienter befüllt werden, was die Performance des Gesamtsystems verbessert.
Viele kennen das Prinzip aus anderen SErverdiensten, wenn man von einem Server mehrere instanze startet – jede instanz bekommt dann einen anderen Port, das bedeutet die Benutzer können sich auf die selbe IP-Adresse mit verschiedenen Ports auf verschiedene SErverinstanzen verbinden. Eine SAP-instanz ist also eine alternative zur Angabe eines anderen Ports.
Danach muss man eine System-ID angeben. Jedes SAP-System, welches ja aus mehreren Instanzen bestehen kann, wie wir gerade gelernt haben, hat eine solche Sytem-ID. Diese System-ID ist dabei für alle instanzen gleich. Es kann aber wiederum auf einem einzigen Serverhost mehrere SAP-Systeme und damit auch mehrere System-IDs haben. Somit ist es beispielsweise möglich, dass die Datenbank für ein sAP-Produkt eine andere SystemID bekommt als das SAP-Produkt, welches sich dieser Datenbank bedient. Sowohl das SAP-Produkt, als auch die Datnebank, können dann selber wiederum mehrere Instanzen haben.
Damit ihr versteht, was in das Feld SAPRouter-String gehört, wann da überhaupt etwas reingehört und wozu man das braucht, schaut ihr euch am besten meinen SAPROUTER-Post an.
Wenn ihr euch dann auf die instanz eines SAP-Systems verbunden habt, bekommt ihr eine Loginmaske, die so aussieht.
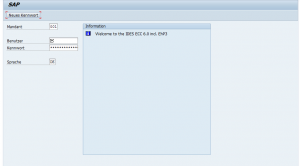
Jede SAP-Instanz kann jetzt wiedeurzm mehrere Mandanten haben. Mandanten sind eine Art geschlossene Benutzerumgebung, das heißt: ein Mandant gibt einer Gruppe von Benutzern eine Reihe von Tabellen und Eingabemasken, mit denen Sie grafisch am SAP-System arbeiten können. Mit einem Mandant kann man nicht auf die Tabellen und Scihten eines anderen Mandanten zugreifen und dort Änderungen bewirken – außer bei mandantenübergreifenden Tabellen, auf die in der Regel nur ADministratoren zugriff haben. in der Regel existiert jedoch immer nur eine einzige Firma, die ein SAP-System verwendet, und deshalb in der Regel auch nur ein Mandant.
Wenn in einem solchen mandanten ein Großkonzern mit mehreren Tochtergesellschaften auftritt, dann werden die einzelnen Geseellschaften in einem Mandanten durhc einen sogenannten Buchungskreis voneinander abgegrenzt.
Ein mandant in modellierungstechnischer Hinsicht ist eine juristisch und organisatorisch eigenständige Einheit. Die Daten eines Mandanten sind gegen die anderen mandanten in der selben SAP-instanz geschützt. Gängig ist es beispielsweise, dass ein Mandant einem konzern entspricht. So kann beispielsweise ein Großkonzern sich selbst und auch seine Tochtergesellschaften in einem einzigen mandanten abbilden – oder ein SAP-System kann mehrere wirtschaftlich unabhängige kleinunternehmen über Mandanten zur Verfügung gestellt werden.
So ist es beispielsweise möglihc, dass es in einer SAP-instanz einen Mandnaten gibt, in welchem sich die Nutzer einer Tochterfirma einloggen, und dort nur Tabellen und Sichten aus den für sie interessanten modulen bekommen, um damit beispielesweise im modul FI/CO Rechnungswesen machen zu können. In einem anderen Mandanten würden sich dann die Mitarbeiter der Mutterfirma auf dem Modul SAP MM einloggen und dort ihrer Arbeit nachgehen. So kann man Nutzer immer von vornherein schon ganz logisch voneinander trennen.
Welche Mandnaten zur Verfügung stellen und was in den einzelnen Mandanten den Usern zur Verfügung steht, legt in der Regel der Administrator im Rahmen des sogenannten Customizings fest.
Customizing
Im Rahmen des Customizings wird das vorinstallierte SAP-System in seinen einzelnen instanzen und Mandnaten auf die Bedürfnisse des Kunden zugeschnitten. Dazu gehört beispielsweise einzustellen, welche Mandanten für welche User verfügbar sein sollen und auf welchen Mandanten welche Module, Tabellen, Sichten und funktionen von den Usern aufgerufen werden können sollen.
Damit der Administrator einen Mandanten nicht von Grund auf neu einrichten muss, liefert SAP bei Installation eines Produkts immer einen Referenzmandanten aus, den Mandnaten 000. In diesem Mandanten darf man nicht praktisch arbeiten, er dient einzig und allein dazu, kopiert und im Anschluss an den Kopiervorgang gecustomized zu werden.
Eine Kopie des Referenzmandanten wird immer gleich mit vorinstalliert, der Mandant 001, der kann also gleich ohne Kopie des 000ers sofort bearbeitet und angepasst werden. Alle weiteren kann man sich vom 000er wieder kopieren und danach loslegen.
SAP EasyAccess
Hat sich der Benutzer letztendlich dann erfolgreich in seinem SAP-Mandnaten eingeloggt, bekommt er die oberfläche SAP Easy Access angezeigt. Das ist sozusagen das grafische User Interface, mit dem er über SAPGUI mit der Anwendungsschicht des SAP-Systems interagieren kann. Hier kann er Tabellenund Sichten abrufen, Abfragen und Eingaben tätigen usw.
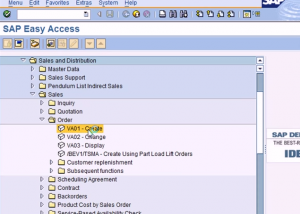
SAP Easy Access ermöglicht die Navigation per Menü. So wäre es beispielsweise möglich, wenn auf dem Mandanten das Modul SAP SD (Sales Distribution) verfügbar ist, über den Menüpunkt Sales and Distribution / sales / Order / VA01 – Create eine Bestellung aufzugeben.
Anstelle der Navigation über einen Menüpunkt kann man auch sogenannte Transaktionscodes verwenden. Oben ist für solche Transaktionscodes extra ein Eingabefeld vorgesehen. Dort hätten wir also den Transaktionscoe VA01 eingeben können, um den selben Effekt zu erreichen.
Jeder SAP-Menüpunkt ist eine Transaktion, also eine vordefinierte Abfolge von Aktionen, die durch ein zugehöriges Dynamisches Programm (DynPro) abgearbeitet werden. Die meisten SAP-programme sind dabei in der eigens entwickelten Sprache ABAP (Advanced Business and Application programming) formuliert. interessanterweise werden Programme in der SAP-Welt nicht als Programme, sondern als Reports bezeichnet. die namensgebung erschließt sich aus der vergangenheit der Sprache ABAP, die früher zur Erzeugung von Berichten (reports) für das Management gedacht war. Bis heute hat sich daher für ABAP-programme der Terminus Report eingebrannt.
dabei gibt es Transkationen, die in der Regel nur die Administration des Mandanten betreffen. Für diese Transaktionen haben in der Regel nur die Administratoren entsprechende Rollen und Rechte,damit normale Nutzer hier nichts verstellen können. Und dann gibt es eben auch noch Transkationen, die für die fachlichen Anforderungen im SAP-Modul gebraucht werden, wie eben die VA01 zum erstellen einer Bestellung.
Ein Administrator kann mit diesen fachbezogenen Transaktionen in der Regel nichts anfangen. Keine Sorge: die Anwender meistens auch nicht :D. Damit Anwender ihre fachlichen Tätigkeiten in einem SAP-System nachgehen können, müssen diese meist Schulungen durchlaufen, damit Sie sich mit dem komplexen geschäftsprozessorientierten Ablauf von SAP-Transaktionen vertraut sind und sich zurechtfinden. Deswegen bietet SAP beispielswiese auch Anwenderschulungen und Anwenderzertifizierungen an, mit denen SAP-Modulanwender nachweisen können, dass Sie die Transkationen in einem SAP-modul beherrschen. Detailwissen in den fachlichen Transkationen sind von einem Administrator normalerweise nicht gefordert, schaden jedoch nicht. Ein ABAP-Entwickler hingegen arbeitet beim Schreiben von Anwendungen meist sehr eng mit den Anwendern eines Systems zusammen und braucht hier meist schon einen etwas besseren Einblick in die Abläufe der Anwenderinteraktion mit dem SAP-System.
Für einen versierten Windows-Anwender ist oftmals der Wunsch da, mit „zwei SAP Logon-Fenstern“ zu arbeiten. in der regel öffnet SAP Logon aber kein zweites Fenster für eine Transaktion.
Der umständliche Weg für das gleichzeitige Arbeiten mit zwei Sessions wäre, sich ein zweites mal über SAP Logon einzuloggen. Ansonsten kann man jederzeit im SAP Easy Access unter Menu / Create Session eine weitere Session eröffnen und somit in mehreren Transaktionen gleichzeitig arbeiten. Natürlich gibt es auch wieder eine Transaktion, mit der man eine neue Session erstellen kann. Dazu gibt man in das Eingabefeld einfach nur /o ein – diese Transaktion startet dann ein neues Fenster mit einer neuen SAP Logon-Session.
Standardparameter
SAP-Anwender arbeiten mit bestimmten Transaktionen in ihrem täglichen Brot- und Buttergeschäft immer wieder. Jemand in der Verkaufsabteilung beispielsweise wird wahrscheinlich täglihc mit der Transaktion VA01 zu tun haben. Oftmals ist es so, dass er in bestimmte Eingabefelder immer die selben Werte eintragen muss, oder zumindest ist es oft so, dass bestimmte Werte immer wiederkehren.
Deswegen kann er für bestimmte Parameter in den Eingabetabellen von SAP Easy Access Standardwerte vorgeben, die standardmäßig immer in diesem Feld drin stehen. Das geht über die Transkation SU3. Dort kann der User sein eigenes User Profil editieren. Im Reiter Parameters kann er die ParameterID eines Parameters und dort dann den Standardwert eintragen.
Die SAP-Organisationselemente
SAP benutzt verschiedene Organisationselemente, um in seinen Produkten festzulegen, welche SAP-instanz für welchen Bereich eines Unternehmens zuständig ist. Mit den SAP Organisationselementen ist es möglich, auf einer einzigen SAP-Instanz unterschiedliche Organisationseinheiten eines Unternehmens mit SAP-Diensten zu versorgen. Desweiteren werden beispielswiese auch Kundendaten mit solchen Organisationselementen hinterlegt, etwa ein bestimmtes unternehmen mit seinen einzelnen Filialen und Standorten.
Die oberste Organisationseinheit ist der Client / Kunde. Bei einem Client handelt es sich um eine juristisch und organisatorisch eigentsändige Einheit. Das kann also beispielsweise eine Tochterfirma sein, oder wenn wir ein SAP-Beratungshaus sind und unseren Kunden ein betreutes ERP-System anbieten, können wir hier die verschiedenen Kunden unseres beratungshauses anbieten, da die informationen der kunden gegenseitig voreinander geschützt sind. Wenn wir ein produzuierebndes Gewerbe sind, können wir unsere Kunden dort hinterlegen. Ein mandant repräsentiert also ein gesamtes Enterprise, dessen hauptquartiere oder seine Main Holding Company.
die nächste Organisationseinheit ist die sogenannte Controlling Area. Hier werden bestimmte Bestandteile des Unternehmens grob geografisch getrennt, also beispielsweise in die Kontinente Europa und Nordamerika.
Danach folgt der sogenannte Company Code. Ein Company Code repräsentiert eine rechtlich unabhängige Einrichitung innerhalb des Enterprise, welches wir mit unserem mandnaten abbilden wollen, also beispielsweise die Niederlassung der firma in Deutschland, die etwa als deutsche AG angemeldet ist, und ein anderer company Code könnte eine britische Limited für dieses Enterprise abbilden. Abhängig vom Company Code werden auch beispielsweise Voreinstellungen für das zutreffende Steuerrecht, den fiskalen Kalender für das Rechnungswesen usw. eingestellt, die Voraussetzungen für die Abgabe von Steuererklärungen und die Währung getroffen. Mehrere Company Codes werden in einer Controlling Area zusammengefasst.
Danach kommen die sogenannten Organizational Units. Sie werden vor allem im SAP-Modul HR (Human Resources) gebraucht. Diese bilden die einzelnen Abteilungen innerhalb eines Company Codes ab. Es gibt also beispielsweise eine Organizational Unit „HR“ (Human Resources) für den Company Code der deutschen AG, aber auch eine Organizational Unit „HR“ für die britische Limited unseres Enterprises. Ebenso gibt es jeweils Einheiten für die Abteilungen Rechnungswesen, Materialmanagement usw.
Darunter liegen die sogenannten Positionen. Diese bilden die Stellen ab, die innerhalb dieser Abteilungen von Mitarbeitern bekleidet werden. Mitarbeiter wiederum werden mit dem Organisationsleemnet Person/User wiedergegeben.
Dann kommen die Sales Organizations, die wieder direkt unterhalb eines Company Codes angesiedelt sind. Diese werden vor allem für das SAP-Modul SD (Sales Distribution) gebraucht. Abhängig von den eingestellten Sales Organizations werden beispielsweise Voreinstellungen für die Allgemeinen Geschäftsbedingungen für die Kunden eines Company Codes getroffen. Hier werden meist Verkaufsstellen eines Company Codes eingetragen.
Unterhalb der Sales organizations gibt es die sogenannten Divisions.
Daneben gibt es die Plants. Plants können Produkte herstellen, verteilen oder eine Dienstleistung bereitstellen. Diese Organisationseinheit wird vor allem im SAP Modul PP (Production Planning) genutzt.
Unterhalb der Plants gibt es sogenannte Storage Locations, welche die Lager abbilden sollen, welche die plants mit Material versorgen können. Diese Einheiten werden vor allem im SAP-modul MM (Materialmanagement) genutzt.
Master Data
Die oben genannten Organisationselemente werden dazu genutzt, um Datensätze zu erzeugen, die das Unternehmen selbst, welches das SAP produkt nutzt, oder dessen Kunden, Mitarbeiter o. Ä. abzubilden.
So besteht beispielsweise ein Personal Master Record aus den Organisationseinheiten Organizational Unit, Position und Person/User. Ein Datensatz für einen mitarbeiter besteht also aus dessen Abteilung, seiner Position und seiner Person / seinem User.
Master Daten sind Daten, die in mehreren Tabellen, Ansichten und Transaktionen eines SAP-Systems wiederverwertet werden können. So können beispielsweise bei mehreren Bestellungseingängen vom gleichen Kunden immer wieder der Master Record von eben diesem Kunden angezeigt werden.
Um also beispielsweise eine Liste aller Kunden anzuzeigen, geht man im SAP EasyAccess-Menü unter Logistics / Sales and Distribution / Master Data / Business Partner rein.
Master Data gibt es nicht nur für Kunden, sondern beispielswiese auch für Materialien. Dazu gehen wir unter Logistics / Materials Management / Material Master / Material.
Master Data heißt Master Data, weil es Daten sind, die nicht nur transkationsübergreifend, sondern auch produktübergreifend verfügbar sind. Die Daten über einen Kundne liegen also beispielsweise im SD-Modul des ERP-Systems vor, im SCM (supply Chain Management) System und können auch im CRM-System (Customer Relationship Management) System vorliegen. Die Anwender des systems haben also transaktions- und produktübergreifend Zugriff auf diese Daten.
Transaktionen
SAP-Produkte sind geschäftsprozessorientierte IT-dienstleistungen: das bedeutet: SAP hilft dabei, Geschäftsprozesse, die in einem Unternehmen vorkommen, etwa der eingang einer Bestellung oder der jährliche Jahresbaschluss im Rechnungswesen, besser zu lösen.
SAP bildet geschäftsprozesse in seinen Produkten digital mittels von Transaktionen statt. Für jeden Geschäftsprozess – etwa den Eingang einre Bestellung – gibt es eine Transaktion. Dabei gibt es allerdings nicht nur Transaktionen für das Abwickeln von Geschäftsprozessen, sondern auch für Administrative Zwecke.
Wann immer möglich, werden bei einer Transaktion existierende Master Records geladen, damit diese nicht erneut eingegeben werden müssen. Liegen also etwa mehrere Bestellungen von ein und dem selben Kunden vor und ist der Kunde neu, müssen dessen Daten nur einmal vom mitarbeiter der Verkaufsabteilung (SD) eingetragen werden.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Eine SLD steht für System Landscape Directory. Sie dient als zentrale Qeulle für infomrationen über die SAP-Systemlandschaft. Dadurch stehen immer informationen zur Verfügung, welche Produkte auf welchen Systemen installiert wurden, sodass man diese Produkte über beispielsweise den Solution Manager warten zentralisiert warten kann. Damit können Software-Lifecycle-Aufgaben geplant werden, beispielsweise das Update bestimmter SAP-Produkte auf den neuesten SP-Level.
Das SLD basiert dabei af einem nicht-proprietären standard der Distirbuted mangement Task Force, genannt Common Information model (CIM).
Das System Landscape Directory unterscheidet zwischen technischen Systemen – also Serverhardware, auf denen später SAP-Lösungen installiert werden können – und den Applikationen, die darauf alfuen. Diese Daten werden automatisch geupdatet – wird eine neue SAP-Kompoenten auf einem technischen System installiert oder entfernt, wird diese information von diesen Produkten an das SLD und von dort automatisch an die anderen Bestandteile der landschaft verbreitet.
Das SLd enthält zwei Warten von Informationen über die Landschaftstopolige:
- Landschaftsbeschreibung: welche Sfotwarekompoenten sind gerade in der Landschaft installiert. dazu werden detaillierte informationen über die Version, das Patch- / SP-Level, die Verbindungen zwischen den Systemen und die informationen über die Hosts (Betriebssytem, Hostname, Datenbank usw.) gespeichert.
- Komponenten information: welche softwarekompoenten können theoretisch in der Landschaft installiert werden? Hier werden die möglcihen Abhängigkeiten und Kombinationen der Lösungen beschirben. Das SLD weiß ganz genau, welches produkta uf welcher Plattform mit welcher Datenbank laufen kann, und bildet hierbei genau die Abhängigkeiten ab, die dazu erfüllt sein müssen.
Alle SAP-Komponenten – und unterstützte Drittanbietrkomponenten – haben Funktionen eingebaut, welche informationen über sich selbst an das SLD schicken und dort hinterlegen.
Das SLD ist eine Komponente von SAP NetWeaver und ist komplett mit Java-technologie implementiert. Sie wird ausgeliefert als jva-komponente auf einem Application Server java. Bei jeder installation eines NetWeaver mit Usage Type Application Server java ist das SLD autoamtisch mit installiert. Da beim SAP Solution Manager auch ein NetWEaver AS Java implementiert ist, aknn man auf dem Solution Manager auch ein lokales SLD betreiben.
Die Clients, welche Infomrationen an das SLD senden, werden Data supplier genannt. Jedes SAP-Produkt und auch unterstüzte Drittanbieterprodukte können als Data supplier für ein SLD dienen, indem man einfach den Hostnamen und Port eingibt.
Clients können – und müssen logischerweise auch – Daten vom SLD lesen können – biespielsweise der solution Manager, wenn er wissen will, welchen SP-Level eine bestimmte SAP-Komponente gerade hat.
Hier ein nützliches Dokument von SAP über das SLD
SLD Topologien
Man kann ein SLD auf verschiedene Arten und Weisen betrieben. Jnede option hat verschiedene Vor- und Nachteile.
Grundsätzlich ist gleich vorweg zu sagen, dass es nicht ein SLD pro Systemlandschaft gibt, sondern mehrere. Es gibt immer ein sogenanntes Central SLD, welches alle informationen sammelt, und mehrere local SLDs.
Dafür gibt es ehrere Gründe. Stellt euch tmal ein großes Unternehmen mit vielen Niederlassungen in verschiedenen Ländern vor. Es wäre verständlich, dass die einzelnen Länder oder sogar Bundesländer ihre Systeme einzeln warten wollen und daher nur informationen über IHRE SAP-Systeme sehen wollen, und nicht auch noch über die SAP-Systeme in Indien oder sonst wo. Dafür braucht man ein dediziertes SLD werlches verschiedene Views auf die Daten des Gesamt-SLds bereitstellen kann.
In meinem post SAP: geschichte und Einführung habe ich außerdem die sogenannte Drei-Stufen-Landschaft vorgestellt. Dabei gibt es eine Landschaft zum Entwickeln neuer SAP-Systemlandschaten, eine zum Testen der zuvor entwickelten Landschaften, und eine zum produktivbetrieb. Natürlich wollen diejenigen, die ein System entwickeln oder testen, ebenfalls ein SLD haben, da die Systeme später im Produktivbetrieb ja auch mit einem SLD betrieben werden. Es wäre also schwachsinn, bie der Entwicklung und beim Test eines Systems ohne SLD zu arbeiten. ES amcht aber keinen Sinn, dafür das selbe SLd wie für den produktivbetrieb zu wählen, da dies zusätzliche Laust auf dem produktiv-SLD erzeugt, zu möglichen Fehlern führen kann, die die produktivlandschaft schädigen können, und weil die Entwickler und Tester nicht unbedingt den selben Vertrauensstatus haben wie ide Administratoren des produktivsystems. Deswegen sollte mana uch hier gesonderte SLDs haben.
Und desweiteren möchte man natürlich die Verfügbanrkiet des SLDs erhöhen, indem man mehrere SLDs aufsetzt, falls eines mal ausfällt.
Wenn es aber nun mehrere SLDs in einer Systemlandschaft gibt, muss es möglich sein, SLD-Daten zwischen diesen SLDs auszutauschen – denn wenn sie sich nicht unterhalten, hat jeder nur einen Teil der Gesamtinformationen über eine Systemalndschaft.
Deswegen gibt es verschiedene Methoden, SLD-Daten zwischen den SLDs auszustauschen:
- Vollautomatische Synchronisation. Wenn in einem SLD Daten geändert werden, werden diese änderungen autoamtisch an die anderen SLds weitergelietet. Die Synchronisation kann uni- oder bidirektional erfolgen. Sinn macht in den meisten Fällen bidirektional, das heißt immer das SLD, bei dem sich etwas an den SLD-Daten änder,t gibt diese an ein anderes SLD weiter. Bei unidirektional würden infomrationen nur weitergegeben werden, wenn sich bei dem SLD etwas ändert, welches als Data supplier definiert würde. Ändert sich was beim empfangenden SLD, sendet diese die informationen nicht weiter. Ausnahme: Man hat eine Art ring-Topologie gebaut, bei welchem im Stille-post-Prinzip ein SLD unidirektional seine Änderungen immer an einen Nachbarn weitergibt, dieser an den nächsten, usw. – bis ein _Kreis geschlossen wird. Die Synchornisation kann asynchron stattfinden. Ist ein SLD also beispielsweise mal down oder wird neugestartet, kann es sich währenddessen stattfindende Änderungen nachträglich von einem Partner-SLD abholen. Diese Synchronisation ist sehr wichtig, wenn man die Verfügbanrkit des SLDs erhöhen will, indem man zusätzliche SLDs hinzufügt, da somit ein automatisches Backup stattfindet. Desweiteren wird diese Synchronisation oft genutzt, wenn man ein SLD mit neuerem Release in die Landschaft integrieren will – man hotl sich die Daten vom alten SLD – ist das abgeschlossen, kann man das alte SLD ebenfalls upgraden oder ausschalten.Wichtig bie der automatischen Synchronisation ist, dass das unique path principle nicht verletzt wird. DAs bedeutet: Daten können immer nur auf einem Weg von einem SLD zum anderen gesendet werden.
- Automatische Weiterleitung von Data Suppliers (Birdge Forwarding). Funktioniert leider nur für bestimmte Daten. Manuell vorgenommene Äönderungen am SLD, etwa Businesssysteme, die für NetWeaver PI gebruacht werden), können nicht weitergeleitet werden. Diese option wird deshalb oft nur dann genutzt, wenn die vollautomatische Snychronisation nicht geht.
- Manueller Datenexport und Datenimport, kombiniert mit dem Transport von SLD objekten mit dem Change and Transport System (CTS+). Eines der SLDs wird als Master SLD ausgewählt – von diesem aus kann man die anderen SLD Instanzen updaten.
in der Praxis werden immer mehrere dieser Mechanismen zur Synchronisation in kobmination genutzt. Dabei darf man aber nicht mehrere Mechanismen für die selben SLD Daten auf dem selben synchornisationspfad nehmen. Man synchronisiert also nicht von SLD A nach SLD B einmal vollautoamtisch und einmal mit automatischer Weiterleitung. Das macht ja schließlich auch keinen Sinn und erzeugt nur unnötigen Datenoverhaead. Es macht aber beispielsweise sinn, mit automatischer Weiterleitung zu synchroniisieren, und manuelle Än derungen, die so nicht wietergeleitet werden könnten, mit Import/Export zu synchronsiieren.
Nun gibt es einige Entscheidungen zu treffen
- wie viele SLD instanzen wollen wir in unserer SLD Landschaft haben
- Wo sollen wir diese SLD Instanzen laufen haben – entweder als dedizierte SLD Systems, die nur idese eine Aufgabe haben, oder verwaltete Systeme wie beim Solution Manager, oder eine Application Systeme, also einem NetWeaver, wo Applikationen drauf laufen
eine sehr wichtige Basis abhängig davon, wie man seine SLD-landschaft pülant, ist die Tatsache, ob man in seiner SAP-Gesamtsystemlandschaft die beiden Lösungen SAP NetWeaver PI und/oder Web Dynpro java applications nutzen möchte.
ohne NetWeaver PI und Webdynpro Java applications
Generell ist es empfohlen, ein SLD für die Entwicklungs- und Testlandschaft (Desing-time-SLD) zu haben, und ein SLD auf dem SAP Solution Manager, welches für die proudktivlandschaft zuständig ist.
Solltet ihr – aus welchem Grund auch immer, eure bestehende SLD-Topologie irgendwann einmal ändern müssen, liefern folgende SAP-notes Infos darüber, wie man bestimmte änderungen an der SLD-landschaft durchführt.
Die SLD data suppliers aller Systeme – also die Komponenten der vom SLD verwalteten Systeme sowohl in der entwicklungs-, Test- als auch in der Produktivumgebung, die ihre Daten an das SLD schicken, schicken diese na das SLD vom Soltuion manager. Somit können bestimmte operationen für alle Komponetnen sämtlicher Landschaften durchgeführt werden. Und desweiteren kann man die Daten ssämtlicher Landschaften von einem einzigen SLD aus administrieren.
Bisher ist das Desing-Time-SLD noch nicht genutzt worden. Wir haben bisher die Data supplier so konfiguriert, dass sie alle das SLD auf dem Solution manager nutzen, egal ob die systeme in einer Produktivumgebung sind oder nicht.
Die SLD-Clients werden so konfiguriert: Die SLD-cleitns aller produktivsteme nutzen das SLD auf dem Solution Manager.
Die SLD-Cleitns der QA- und Entwicklungssysteme nutzen das Design-time-SLD.
Jetzt werdne sich einige von euch vielleicht denken: Ok…. wait what?
Also: Zurzeit ist es so: die Data suppliers aller Systeme senden technische informationen (beispielsweise überinstallierte SAP-Produkte und Drittanbieterprodukte auf dem System, installierte datenbankinstanzen auf dem System, Datenbankparameter usw.) nur an das SLD des SAP Solution Managers. Nur das SLD des SAP Solution managers verfügt also zurzeit über Landschaftsinformationen. Und derzeit sind auch nur die SLD-Clients der proudktivsyteme dazu in der Lage, Daten vom SLD des solution managers zu lesen, da nur sie auf das SLD des SolMan zugreifen. Die Qa- und Entwicklungssysteme greifne auf das noch leere SLD in der Design-Time zu.
Damit die QA- und Entwicklungssysteme mit dem Design-Time-SLD nun was anfangen können, müssen wir eine Art Synchronisation zwischen dem SolMan-Central-SLd und dem Design-Time-SLD hinkriegen. Dazu nutzen wir eine unidirektionale vollautomatische Synchronisation vom Central-SLD des SolMan zum Desing-Time-SLD. Das heißt: Alle Informationen und Änderungne im Solman SLD werden in das Design-Time-SLD übernommen.
Der Grund dafür, dass man die QA- und Entwicklungssysteme nun nicht direkt auf das Central-SLD zurgeifen lässt, ist der, weil es dadurch zu Problemen auf dem produktiven Central-SLD kommen könnte. So werden alle kritischen Prozeduren und Transaktionen der QA- und Entwicklungssysteme praktisch nur auf dem Design-Time-SLD durchgeführt und das Central-SLD ist sicher.
Mit NetWeaver PI und webdynpro Java applications
Die nutzung von NetWeaver PI und Webdynpro Java Applications verändern das Design ein wenig. Wir haben auch hier ein Design-Time-SLd für Entiwkclungs- und WA-Systeme. Wir hjaben auch hier ein SLD auf dem SAP Solution Manager. Was neu hinzukommt ist, dass wir nun zusätzlich ein SLD für unsere produktivsysteme haben.
in diesem Szenario ist das Central SLD nicht das SLD auf dem SolMan, sondern das SLD für die Produktivumgebungen. Alle Systeme in der Landschaft schicken mit ihren data supplieren ihre informationen an das Central-SLd. Auch die Data supplier des SLD auf dem Solution Manager schicken ihre Daten an das Central SLD der produktivumgebung.
Die SLD-Cleints werden dann wie folgt konfiuguriert: der SAP Solution manager nutzt sein eigenes SLD. die produktivsystem holen sich ihre SLD-Daten vom Central-SLD, und die Test- und QA-Systeme nutzen das Desing-time SLD.
damit das ganze funktioniert, müsen auch hier die Daten aus dem Central-SLd an die bieden anderen SLDs weitergegeben werden. Das geschieht auch hier meist über eine undirektionale vollautomatishce Snchronisation. Das Central-SLd braucht aber manchjaml zusätzlich informationen über Business Syteme, Produkte und Softwarekompontenen aus der Testumgebung, weil diese Daten von NetWeaver PI gebraucht werden. Dazu exportiert man die Daten aus dem Design-Time-SLD auf das Central-SLD ü+ber das CTS+.
Landschaften in der Praxis
Die beiden oben gezeigten Szenarien zeigen uns also, dass wir mehrere SLDs brauchen. DAbei müssen diese SLds aber nicht extra auf einem besonderen Serverhost installier sein. die SLDs sind hierbi als logische Systeme zu sehen. Diese logischen Systeme können auch mit anderen logischen Systemen auf einem einzigen physikalischen Server laufen. Beispielsweise wäre es im Szenario mit NetWeaver PI und/oder Web/Dynrpo-applikationen möglich, dass das Design-time-SLD auf dem selben Host läuft, der NetWeaver PI zur Verfügung stellt.
Meistens wird zusätzlich zu den hier aufgezeigten SLDs ein sogenanntes Backup-SLD eingerichtet. dieses Basckup-SLD erhält die Datena us dem jeweiligen Central-SLD per unidirektionalem vollautomatischen Backup. Unter zuHilfenahme von virtuellen IP-Adressen (VIPA) ist es möglich, bei Bedarf sofort auf das Backup-SLD zu wechseln, wenn das Central-SLD mal Probleme hat.
die oben dargestellten Szenarien sind natürlich immer nur eine Stndardempfehlung. Man kann diese Szenarien jeweils nach eigenen Bedürfnissen customizen. Beispielsweise könnte es sinnvoll sein, dass eine Web Dynpro Anwendung ihr eigenes SLD nutzt und dazu Daten vom Central-SLD eingespeist bekommt.
Desiweteren kann es ja möglich sein, dass ein Beratungshaus oder ein Hosting Provider die SAP-Systemlandschaften mehrerer Kunden betreut. Hier könnte es beispielsweise sinnvoll sein, für jeden Kunden eines der besprochenen szenarien zu installieren, und von diesen Central-SLDs die Daten an ein Master-SLD ´weiterzuleiten, welches die SLD-.Daten aller Kunden enthält.
Daten in einem SLD, welche manuell erstellt wurden, werden nicht automatisch synchronisiert. diese müssen über die import-/Exportfunktion verteilt werden.
| SAP-Note-Nummer | Titel | Beschreibung |
| 9355474 | Grupieren von SLD INstanzen | Diese Note beschreibt das zusammenführen von zwei SLD instanzen indem man den inahtl von einem in ein anderes SLD importiert |
| 936318 | Teilen von SLD instanzen | Diese Note beschreibt wie man eine SLD Instanz in zwei oder mehrere aufteilt |
| 935245 | Bedeutung des Object Server SLD PAramters | diese Note beschreibt die konsequenzen von Änderungen an einem SLD Server, die notwendig sein köntnen, wenn man ein SLD teilt |
| 720717 | Reduzieren der Anzahl von SLDs | Diese Note beschreibt was man in netWeaver PI machen muss, wenn man mehrere SLDs zusammenführt |
Was ist die LMDB?
Die LMDB ist eine Komponenten vom SAP Solution M;anager, die mit dem Release 7.1 eingeführt wurde. die LMDB ist das Tool zur zentralisierten Verwlatung von Landschaftsdaten im SAP Solution Manager. die LMDB holt sich die informationen aus dem SLD durhc vollautoamtische Synchronisation. Der dadurch erworbene Inhalt enthält sowohl (technische Systeme, Business Systeme, manuell erstelle Produkte, Softwarekomponenten usw.)
Statt also auf dem Solution manager ein eigenes SLD zu haben, löäuft auf diesem die LMDB.
Für die Empfehlungen des Szenarios ohne NetWeaver PI und ohne Web Dynpro Anwendungen ändert isch nichts – hier sollte man weiterhin das oben beschriebene Szenario mit SLD anwenden.
Wenn man jedoch NetWeaver PI bzw. web Dynpro Anwendungen nutzen möchte, sollte man im unteren Szenario etwas ändern. statt einem SLD läuft auf dem Solution Manager die LMDB, welche sich die Daten vom Central SLD holt. Das Central Runtime SLD schickt seine Daten an die LMDB des SolMan durhc vollatuatomsiche Synchronisation.
Ein Hosting Provider hätte hier wieder die Central SLDs von zwei verschiedenen Kundenlandchaften. Anstelle eines Master SLDs kann er sich die daten an das LMDB einex zentralen SolMans schicken lassen.
Dabei muss aber auch hier das unique path principle erfüllt werden. Wenn sich die beiden SLDs untereinander bereits synchronisieren, dann darf nur eines der beiden SLDs mit dem LMDB verbunden sein, weil sonst die Daten der beiden SLDs auf zwei verschiedenen Wegen zum LMBD laufen können.
Der umgekehrte Weg: meherere LMDBs von einem einzigen central SLD speisen zu lassen, ist hingegen zulässig.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>